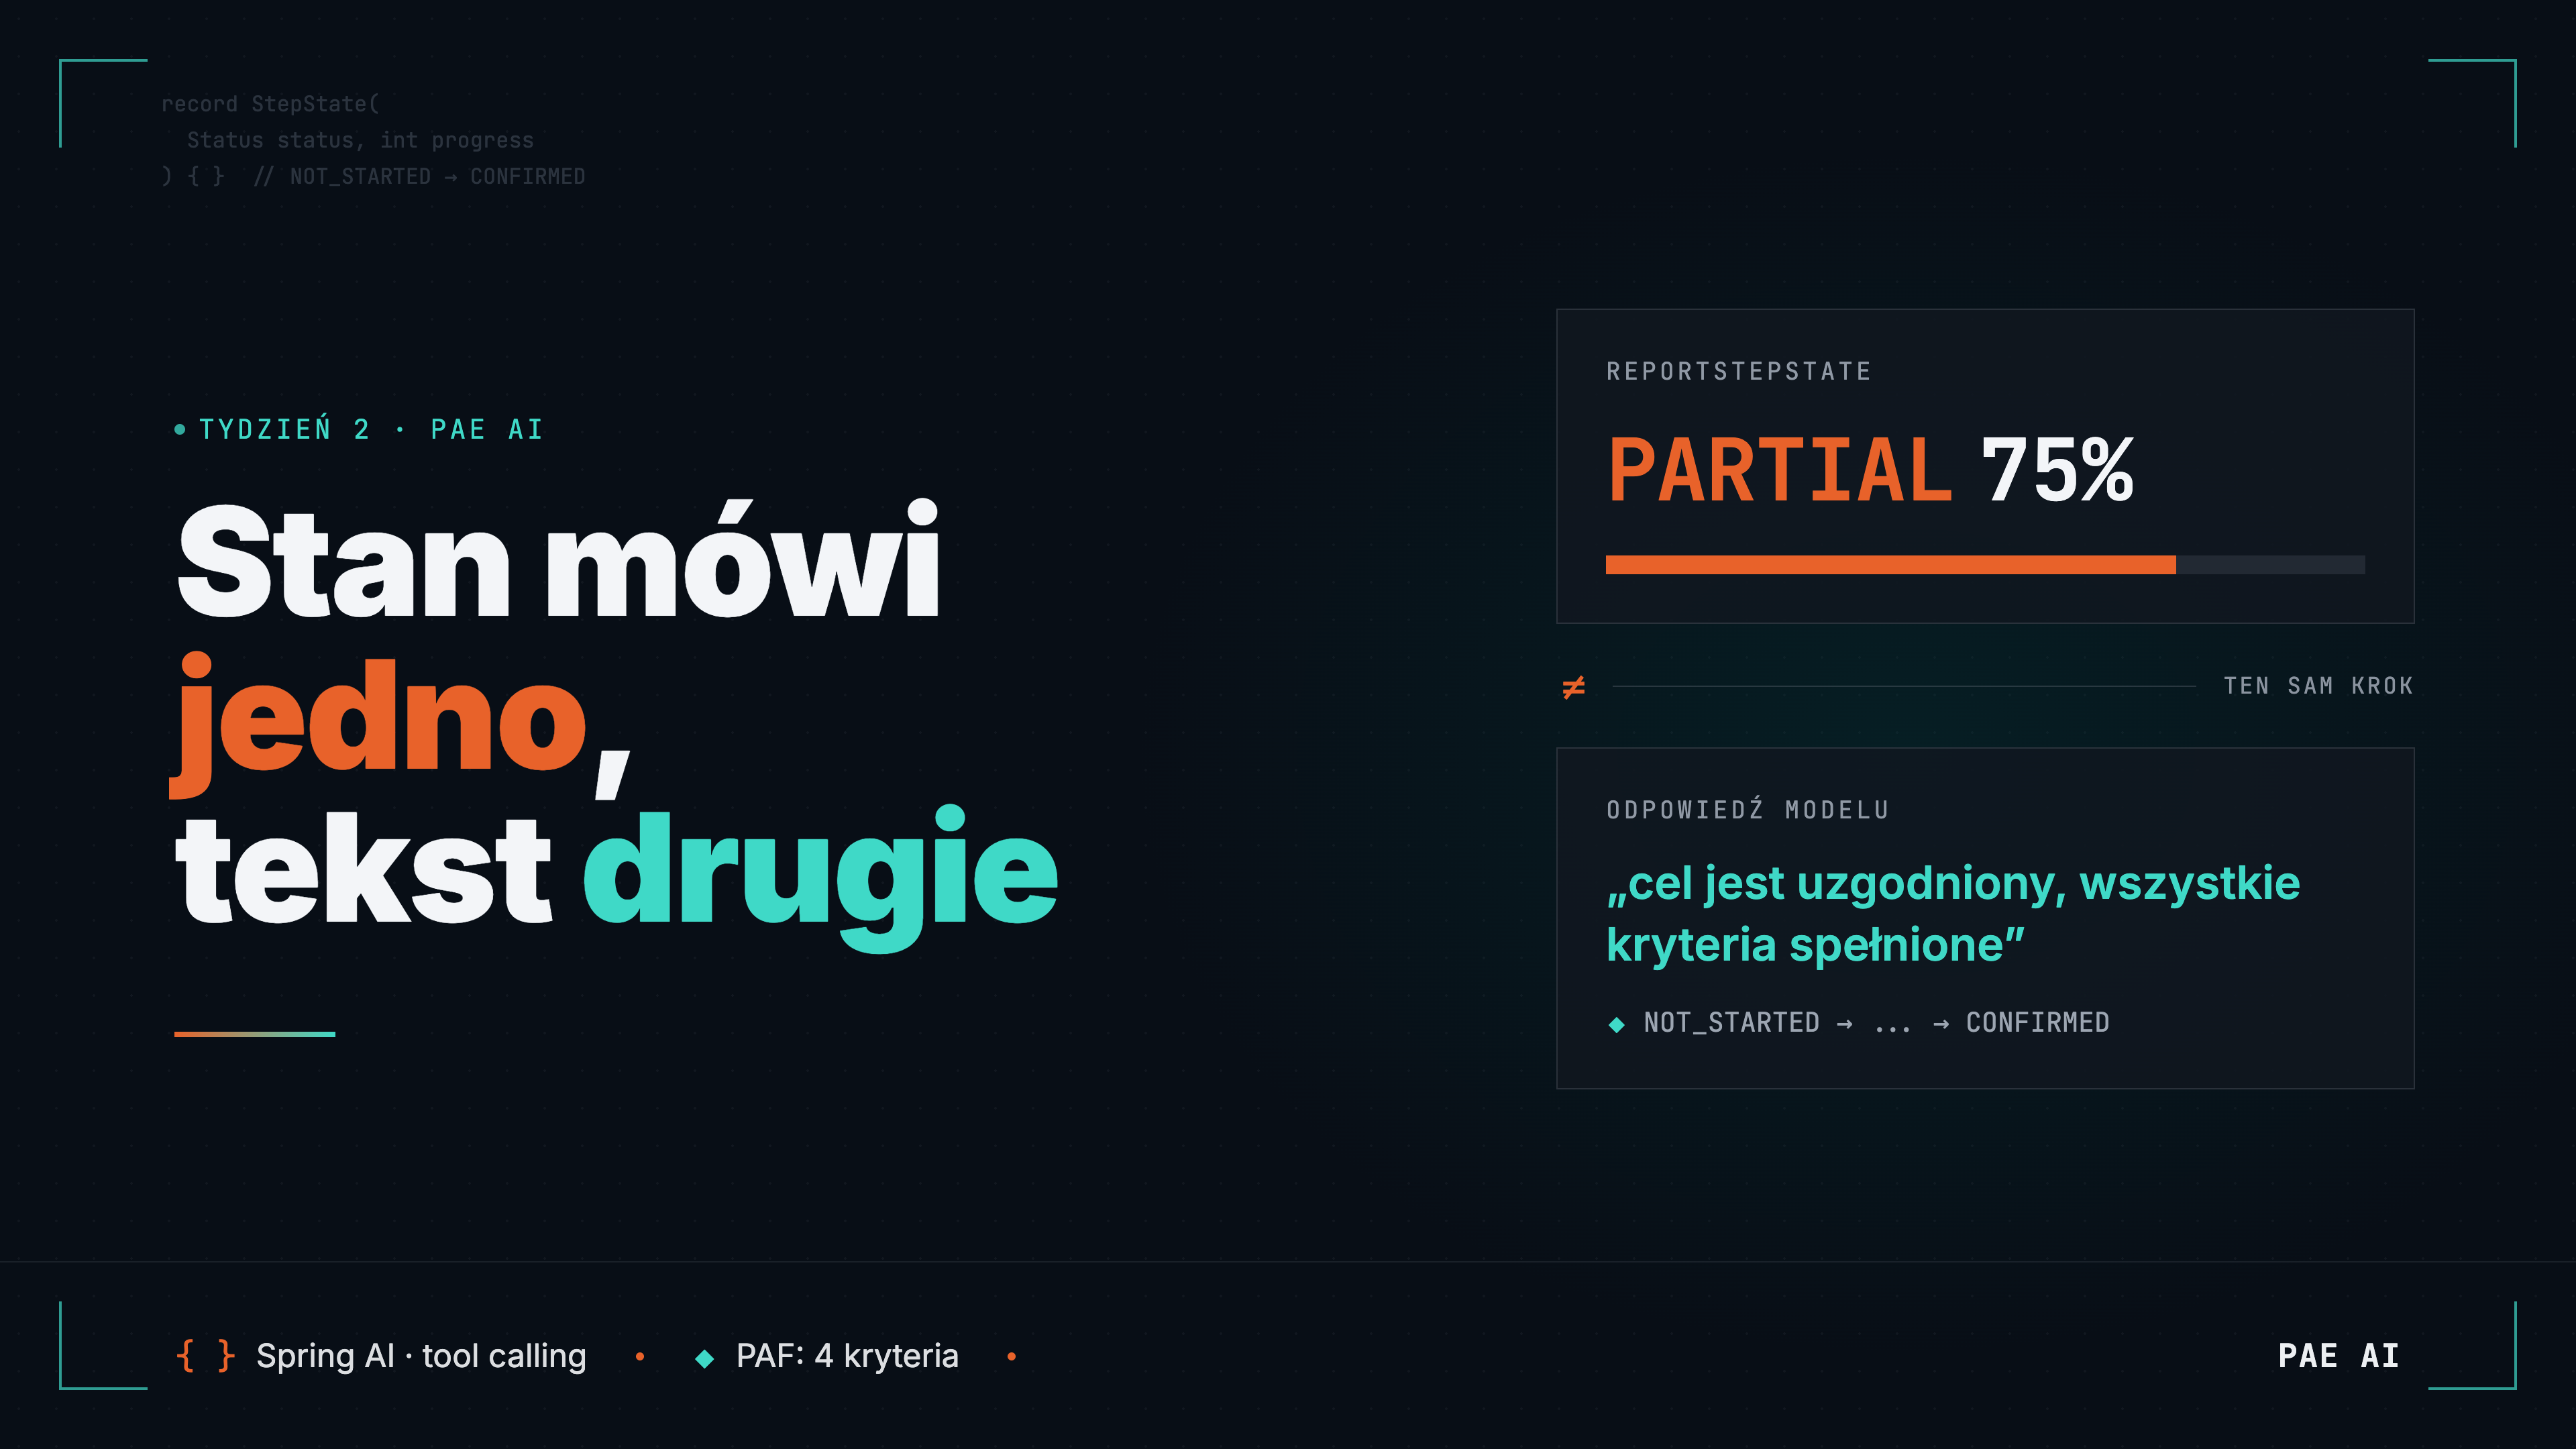
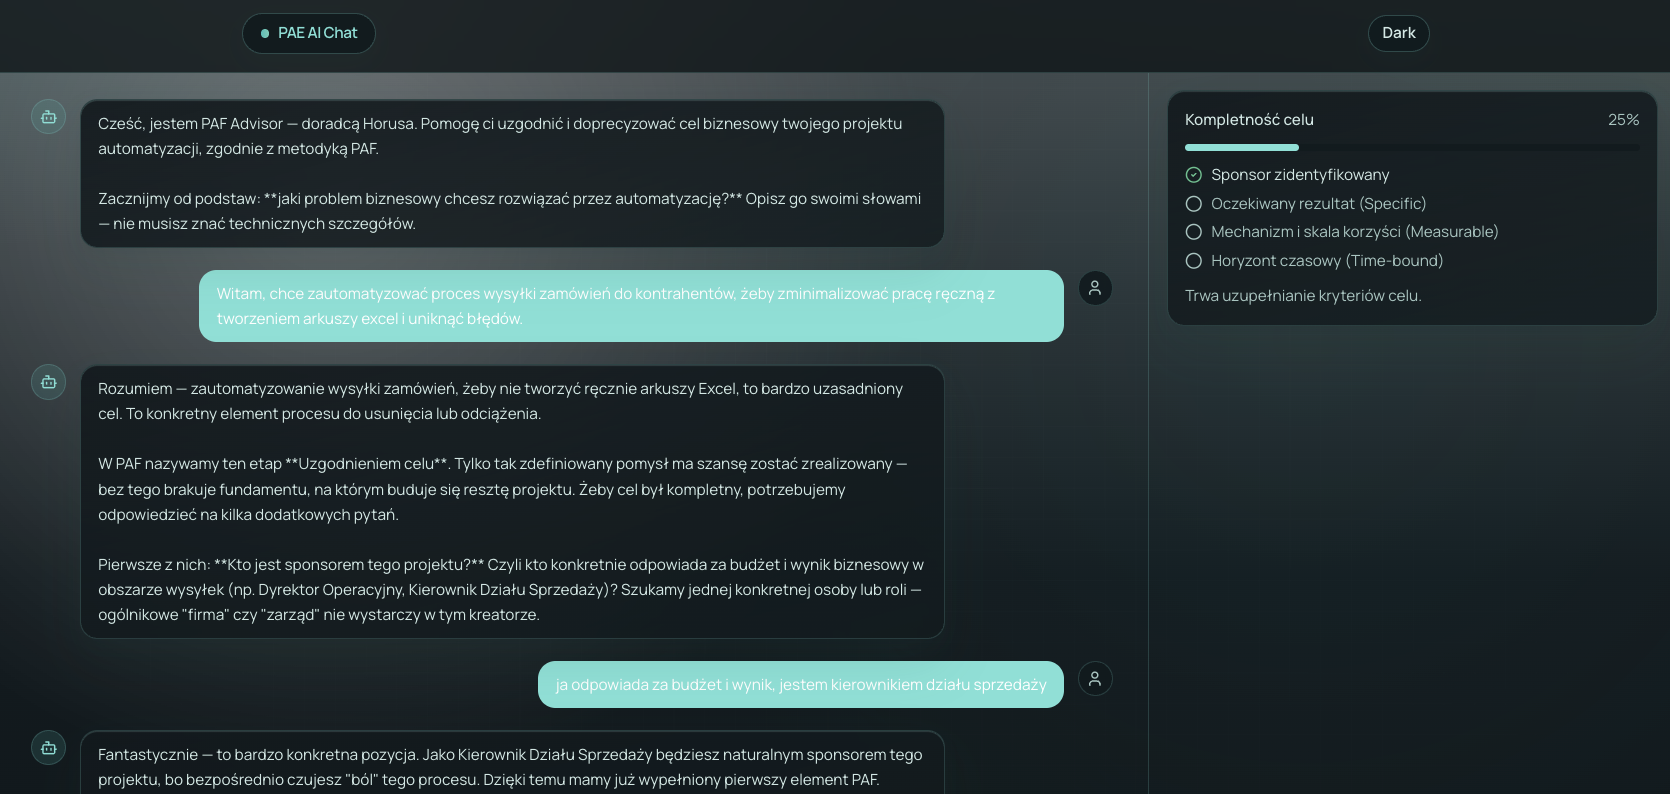
Agent z tygodnia 1 prowadził rozmowę, ale nie miał pojęcia, kiedy ją skończyć — nie wiedział, czy klient powiedział już wystarczająco dużo, żeby uznać zadanie PAF “Uzgodnienie celu” za zamknięte. Tydzień 2 miał to zmienić: dać agentowi jawny stan rozmowy, utrzymywany między turami, i pokazać go na żywo jako procent kompletności.
Problem
Etap 1 metodyki PAF (“Korzyści”) wymaga czterech ustaleń: sponsora, oczekiwanego rezultatu, mechanizmu i skali korzyści oraz horyzontu czasowego — trzy z nich pokrywają się wprost z kryteriami SMART (S/M/T), pozostałe dwie litery (A/R) należą do innych zadań PAF. W tej iteracji świadomie zostawiliśmy je poza zakresem. Bez jawnego stanu widzieliśmy dwa ryzyka: agent mógł zamknąć rozmowę przedwcześnie, zanim wszystko jest ustalone, albo bez końca dopytywać o coś, co klient już powiedział.
Celem tej iteracji był endpoint i panel, który po każdej turze pokazuje, ile z tych czterech kryteriów jest już
spełnione — bez osobnego etapu oceny kompletności przez model. Przyjęliśmy celowo rygorystyczną regułę: każde
kryterium ze statusem SATISFIED daje 25 punktów procentowych, a pozostałe dają 0.
Nie interpretujemy więc tego wyniku jako „pewności modelu”, tylko jako prostą odpowiedź na pytanie: ile wymaganych kryteriów mamy już spełnione.
Stan rozmowy zamiast pytania modelu za każdym razem
W tygodniu 1 zapowiadaliśmy ocenę kompletności przez structured output, czyli odpowiedź, w której model zwraca
nie tylko swobodny tekst dla klienta, ale też dane w ściśle ustalonym formacie. Plan był prosty: w jednym wyniku
model miał zwrócić tekst oraz stan rozmowy. W Spring AI taki stan odbiera się przez
.entity(CompletenessJudgement.class): framework bierze JSON z odpowiedzi modelu i mapuje go na obiekt Javy
CompletenessJudgement.
Ten pomysł rozbija się jednak o ograniczenie streamingu. .entity() działa tylko z .call(), które zwraca całą
odpowiedź po jej ukończeniu, a nie z .stream(), które wysyła tekst fragmentami. Model musiałby więc najpierw
zakończyć odpowiedź, aby framework mógł odczytać stan; użytkownik nie zobaczyłby jej token po tokenie. Można
ręcznie streamować JSON i sparsować go po zebraniu całości, ale stan nadal byłby dostępny dopiero na końcu, a
obsługa streamu po stronie UI byłaby bardziej złożona.
W tej iteracji wybraliśmy więc tool calling — model zgłasza przez niego, które elementy celu uznaje za
ustalone, jeszcze zanim napisze odpowiedź dla klienta. Tool call to prośba modelu, aby aplikacja wykonała
udostępnioną mu funkcję; tutaj funkcją jest reportStepStateTool, która zapisuje ocenę stanu rozmowy. Aplikacja
ją wykonuje i na podstawie zapisanego stanu wylicza procent kompletności oraz to, czy rozmowa może przejść do
potwierdzenia. Panel tylko odczytuje ten zapisany stan.
Role są tu wyraźnie rozdzielone. Ocenę treści zostawiamy modelowi — to on interpretuje wypowiedź klienta i decyduje, czy dane kryterium jest już spełnione. Kod tego nie weryfikuje. Kod pilnuje za to jednej, sztywnej reguły procesu: do potwierdzenia celu potrzebne są wszystkie cztery ustalenia naraz.
To nie jedyny sposób śledzenia stanu rozmowy — rozważaliśmy jeszcze m.in. jedno wywołanie łączące stan i odpowiedź oraz osobny model-ekstraktor obok modelu-rozmówcy.
Ślepa uliczka: tool calling skonfigurowany, ale nigdy niewykonany
Panel kompletności uparcie pokazywał 0%, niezależnie od przebiegu rozmowy — mimo że mechanizm end-to-end
wyglądał poprawnie: tool reportStepStateTool był zarejestrowany, aplikacja liczyła kompletność, endpoint ją serwował.
Log wymiany między aplikacją a modelem rozstrzygnął to w minutę: w tekście odpowiedzi model poprawnie odwoływał
się do ustalonego sponsora, ale w 12 turach i kilku sesjach nie było ani jednego tool calla. Na tej podstawie
wywnioskowaliśmy, że brakowało mu wyraźnego nakazu użycia funkcji w prompcie systemowym. W naszej konfiguracji sam
opis funkcji reportStepStateTool mówił modelowi, co ona robi, ale nie kiedy ma ją wywołać. Dlatego dodaliśmy ten drugi
komunikat wprost do system promptu, czyli instrukcji dołączanej do każdej tury rozmowy.
Znaleźliśmy to ręcznie, przeglądając log — dokładnie taką kontrolę docelowo mają przejąć ewaluacje z tygodnia 3.
Stan mówi jedno, tekst drugie
Ten sam mechanizm ujawnił też inny rodzaj awarii — dla nas najciekawszy w tym tygodniu. W rozmowie, o automatyzacji
wysyłki zamówień, model poprawnie zgłosił expectedOutcome jako PARTIAL. Dwie tury później, mimo że klient nic nowego
o tym kryterium nie powiedział, model napisał w podsumowaniu “cel jest uzgodniony, wszystkie kryteria
spełnione” — i dodał formułę zapraszającą do kontaktu z Horusem. Panel kompletności, czytany deterministycznie
ze stanu, bez drugiego wywołania modelu, pokazał w tej samej turze 75%.
Z punktu widzenia mechanizmu tool call zadziałał zgodnie z oczekiwaniem: zwrócił modelowi poprawnie przeliczoną fazę (IN_PROGRESS),
czyli informację, że przynajmniej jedno kryterium nadal wymaga ustalenia. Wszystkie cztery spełnione kryteria
dają fazę READY_FOR_CONFIRMATION; dopiero jawne potwierdzenie klienta zmienia ją na CONFIRMED.
Wynik tool calla trafił do kontekstu tuż przed dalszą generacją, a mimo to model napisał sprzeczną z nim narrację.
Wdrożyliśmy pierwszą warstwę obrony: obok oceny kompletności (phase), wynik reportStepStateTool niesie teraz nowe pole guidance
z dodatkową instrukcją dla modelu. W fazach NOT_STARTED i IN_PROGRESS — czyli dopóki nie
wszystkie kryteria są spełnione — guidance wprost wylicza brakujące kryteria i zakazuje pisania podsumowania.
W READY_FOR_CONFIRMATION, CONFIRMED i BLOCKED agent nie powinien już dopytywać, więc narzędzie zwraca
inną treść:
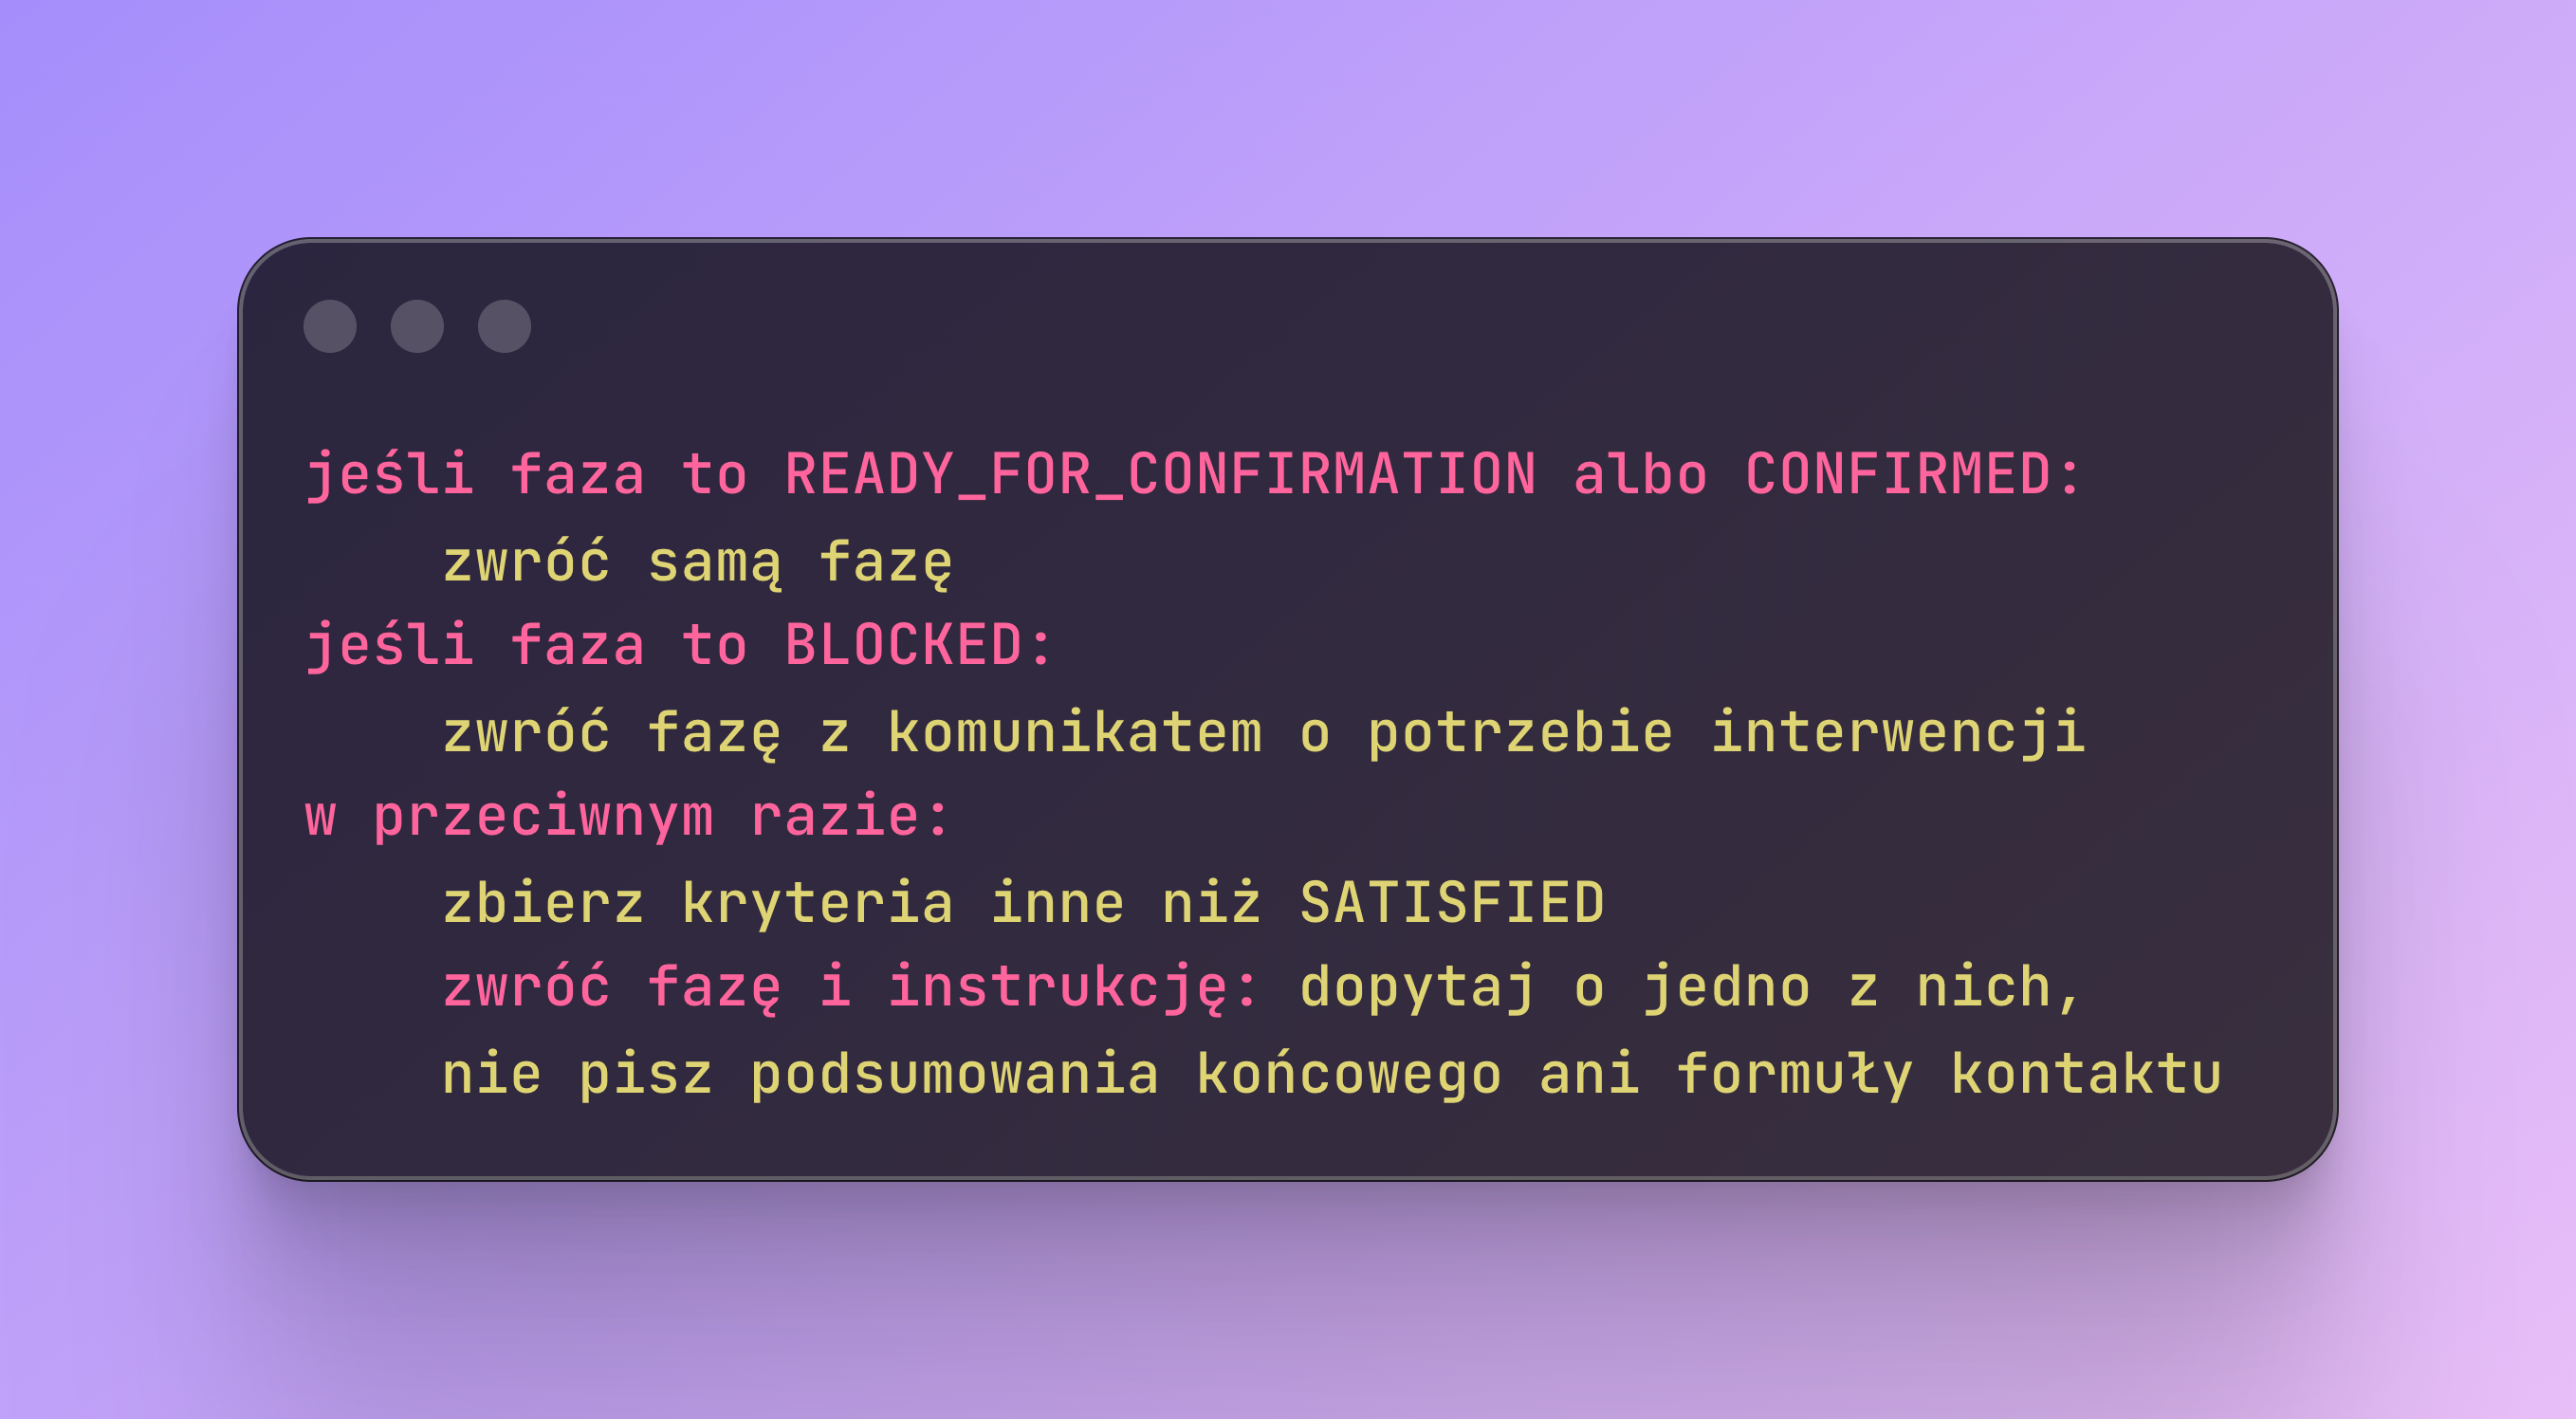
Po usunięciu technicznych identyfikatorów, instrukcja dla modelu wygląda tak, gdy dwa z czterech kryteriów wciąż
nie są SATISFIED:
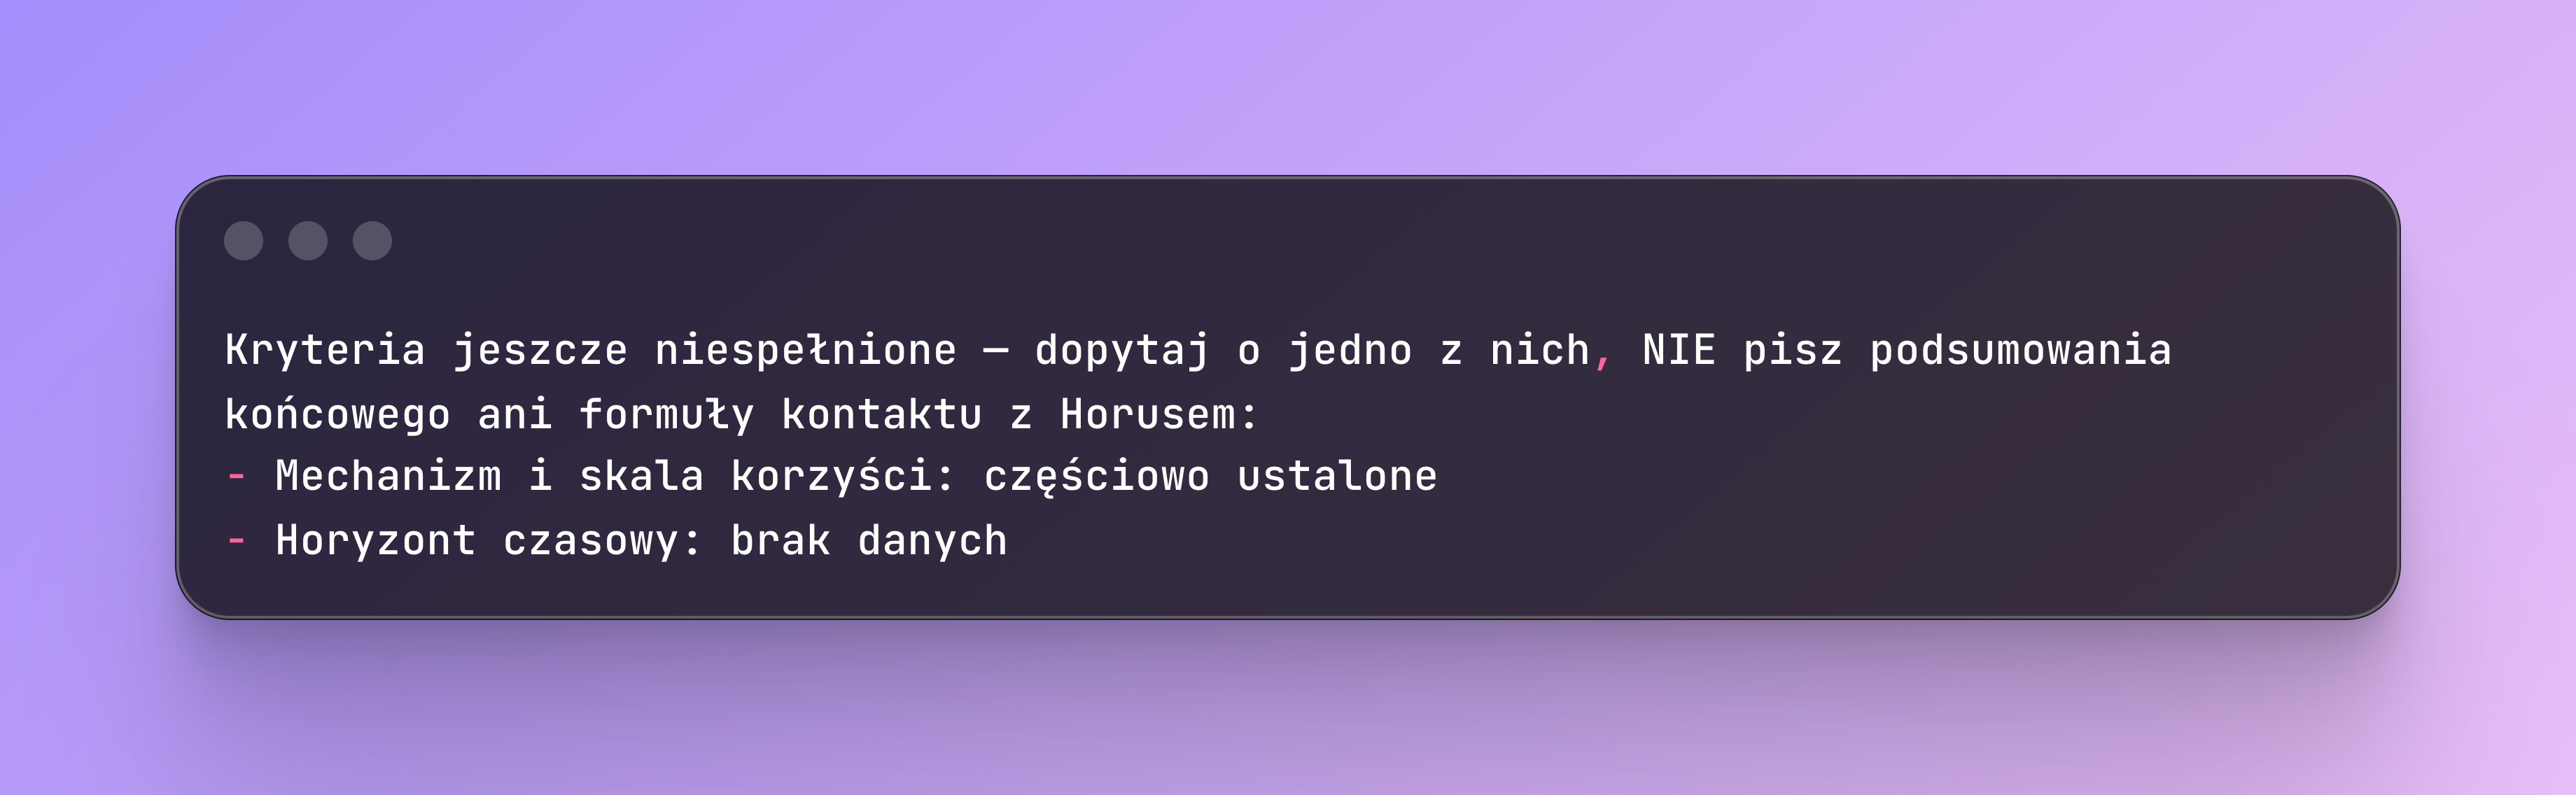
Ta instrukcja trafia do modelu tuż przed dalszą generacją, a nie tylko raz, w statycznym prompcie. W literaturze zjawisko pomijania istotnych informacji ginących w środku długiego kontekstu bywa nazywane „lost in the middle”. Zakładamy, że podanie tej instrukcji blisko punktu decyzji zwiększa szansę, że model ją uwzględni. Nie traktujemy tego jednak jako gwarancji.
Ta zmiana ma zmniejszać ryzyko rozjazdu, ale nie daje gwarancji: instrukcja nadal jest tylko częścią kontekstu modelu. Jeżeli chcemy, by fragment odpowiedzi był bezwzględnie zależny od stanu, aplikacja powinna go sama złożyć albo sprawdzić po wygenerowaniu. Na razie wdrożyliśmy pierwszą, promptową warstwę; pozostałe rozwiązania zostają w backlogu.
To jest dla nas ważniejszy wniosek niż sama poprawa promptu: prompt może zmniejszyć prawdopodobieństwo błędu, ale nie powinien być jedynym mechanizmem egzekwującym regułę procesu. Gdy treść komunikatu zależy od stanu krytycznego dla procesu, docelowo aplikacja powinna tę zależność sprawdzać albo sama budować taki fragment odpowiedzi.
Ograniczenie zaobserwowane po drodze: model uruchomiony w naszej infrastrukturze (gemma4:26b) czasem
zwracał uszkodzone dane w wywołaniu funkcji — na przykład niepoprawny JSON. W naszej konfiguracji nie mogliśmy
zakładać poprawności danych zwracanych przez model, dlatego aplikacja musi je po otrzymaniu sprawdzić i odrzucić błędne.
To osobna oś: czy lokalnie uruchamiany model daje wystarczająco dobre wyniki. Pełne porównanie z API planujemy
na tydzień 5.
Rezultat
| Co działa po tej iteracji | Jak to widać |
|---|---|
| Jawny stan celu | Po każdej turze panel pokazuje cztery kryteria: sponsor, rezultat, mechanizm/skala i horyzont. |
| Procent kompletności | 0%, 25%, 50%, 75% lub 100% — wyłącznie za kryteria w pełni spełnione. |
| Odczyt bez dodatkowego LLM | Panel i endpoint odczytują zapisany stan; nie uruchamiają osobnej oceny rozmowy. |
| Fazy procesu | Pięć faz od NOT_STARTED do CONFIRMED lub BLOCKED; gotowość wymaga czterech spełnionych kryteriów. |
| Ochrona przed rozjazdem stanu i tekstu | Model dostaje bezpośrednią instrukcję wynikającą z aktualnego stanu; mocniejsze egzekwowanie zostaje w backlogu. |
Z naszej perspektywy najważniejszy jest ostatni wiersz: mamy działający, czytelny stan i endpoint, który go pokazuje, ale obecna ochrona przed sprzeczną narracją jest tylko instrukcją dla modelu. To świadomie otwarty temat, nie przeoczenie.
Co dalej
Najważniejszym brakiem, który ujawnił ten tydzień, nie był dla nas kolejny guardrail, lecz sposób wykrywania błędów: znajdowaliśmy je ręcznie, w pojedynczych rozmowach i logach. Po zmianie promptu nie mamy jeszcze automatycznej odpowiedzi na pytanie, czy agent nadal aktualizuje stan celu poprawnie, nie kończy rozmowy za wcześnie i nie psuje zachowania, które działało wcześniej.
Temat tygodnia 3 to ewaluacje i testy regresyjne promptów: zbudujemy w Javie powtarzalny zestaw scenariuszy, który po każdej zmianie pokaże, czy agent nadal zachowuje się zgodnie z założeniami.
Każda zmiana promptu jest hipotezą, nie poprawką: bez pomiaru wiemy tylko tyle, że w kilku rozmowach zadziałała. Budowa agenta jest z natury iteracyjna, a ewaluacje są tym, co odróżnia iterację od zgadywania — i dopiero one pozwalają odpowiedzialnie wpiąć agenta w realny proces biznesowy.