PAE (Pragmatic AI Enablement) to nasz wewnętrzny program. Co tydzień jedna osoba bierze jeden temat z AI, ma trzy dni na eksperyment i jeden dzień na opisanie wyników. Pokazujemy fragmenty kodu, a także popularne pułapki, o których niewiele się mówi.
Agent, którego w programie budujemy, jest doradcą po naszej metodyce PAF, czyli Pragmatic Automation Framework. Rozmawia z klientem o celu automatyzacji i pilnuje, czy padły wszystkie potrzebne ustalenia. Domyślnie chodzi na modelu z API. Ten tydzień był o tym, czy da się go posadzić na modelu uruchomionym na jednej maszynie w biurze.
Masz jeden sprzęt i kilkadziesiąt modeli
Maszyna to mini-PC z AMD Ryzen AI Max+ 395 (Strix Halo): 128 GB pamięci zunifikowanej, zintegrowana karta Radeon 8060S. Modeli, które się na niej mieszczą, są dziesiątki. Ranking z internetu nie powie, który z nich poprowadzi rozmowę po polsku, poprawnie zawoła nasze narzędzie i zrobi to na tyle szybko, żeby rozmowa nie wisiała.
W tygodniu 3 zmierzyliśmy jedno: ten sam zestaw 18 scenariuszy dał 18/18 na modelu z API i 2/18 na modelu lokalnym wziętym z palca. Wybór modelu okazał się decyzją projektową, nie kosmetyczną. Zadanie na ten tydzień: zamienić ten jeden punkt w uszeregowaną listę, mierzoną na naszych scenariuszach.
Czy w ogóle warto stawiać model u siebie? Przy niskim wolumenie API wychodzi taniej. Lokalny sprzęt zwraca się dopiero przy kilkudziesięciu milionach tokenów miesięcznie. Ale jest argument, którego cena nie przebija: dane klienta i tak nie mogą wyjść z firmy. To był powód, żeby sprawdzać.
Dlaczego lokalny model bywa wolny i co z tego wynika przy wyborze
Listę szeregujemy dwiema liczbami: ile scenariuszy model przechodzi i jak szybko odpowiada. Zacznijmy od szybkości, bo tu jest najwięcej niespodzianek.
Krótka odpowiedź: o prędkości decyduje przepustowość pamięci, nie moc obliczeniowa. Przy
generowaniu model czyta wszystkie swoje aktywne wagi raz na każdy token, więc
tok/s ≈ przepustowość pamięci ÷ bajty na token. Nasza maszyna ma jedną pulę pamięci wspólną
dla CPU i GPU (128 GB, ~256 GB/s). Dedykowana karta graficzna ma własną pamięć tylko dla GPU
(VRAM), za to kilka razy szybszą, rzędu 1000 GB/s. Stąd cztery rzeczy, na które patrzeć.
Rozmiar i aktywne parametry. 128 GB sprawia, że pojemność prawie nigdy nie jest problemem.
Problemem jest, ile bajtów trzeba przeczytać na token. qwen3.8:27b waży 17,7 GB → sufit
~14 tok/s, zmierzone 13. Szybszy procesor tego nie naprawi. Jedyne wyjście to zmniejszyć samą
liczbę bajtów wag czytanych na token: mniejszy model, mocniejsza kwantyzacja albo MoE.
MoE czy model gęsty. Model gęsty aktywuje wszystkie parametry na każdy token, MoE (mixture
of experts) tylko kilku „ekspertów” z dużo większej puli: qwen3.6:35b-a3b to 35B łącznie
i ~3B aktywnych, więc na tej karcie czyta ułamek bajtów i jest wyraźnie szybszy. Szybki test na
własnym sprzęcie: tok/s × rozmiar pliku w GB (uproszczenie — pomija KV cache i aktywacje) daje
w przybliżeniu przepustowość pamięci, jakiej model faktycznie potrzebuje. U nas karta ma
~256 GB/s, więc wynik powyżej tej wartości jest dla modelu gęstego fizycznie niemożliwy — musi
to być MoE. gemma4:26b przy 17 GB i ~40 tok/s wychodzi na ~680 GB/s, ponad dwa razy więcej niż
karta ma fizycznie — więc mimo nazwy to MoE. Cena MoE: więcej znanych błędów tool-callingu
w Ollamie.
Kwant. Kwantyzacja to zaokrąglenie wag modelu do mniejszej liczby bitów — mniej bajtów do przeczytania na token, kosztem precyzji. Ten sam model w Q8 waży dwa razy tyle co w Q4 i o tyle wolniej dekoduje. Kusi, żeby zejść niżej, ale Q4_K_M opisuje się jako podłogę. Poniżej degraduje się dokładnie to, na czym nam zależy: niezawodność JSON-a w wywołaniach narzędzi. Q4 potrafi sypnąć niepoprawny JSON pod obciążeniem. Bierzemy Q8 tam, gdzie latencja pozwala.
Tool calling. Agent zgłasza stan przez wywołanie narzędzia; model, który tego nie robi, po prostu nie działa. Flaga „umie tool calling” w rejestrze to nie to samo co „woła je niezawodnie”. Ollama nie ogranicza gramatycznie argumentów, więc słabszy model wysyła zepsuty JSON albo pomija wywołanie mimo jednoznacznej wiadomości. Sprawdzamy to wprost. Ta sama teza powtarza się poza nami: przy agencie liczy się nie liczba parametrów, tylko czy model trafia w narzędzie.
Piąta, mniejsza oś: przełącznik myślenia. Model, który zawsze „myśli”, generuje setki niewidocznych tokenów na turę i wygląda jak wolny sprzęt. Wrócimy do tego przy Ollamie.
Jak zawężaliśmy listę
Kandydatów bierzemy z ollama.com/search?c=tools
skrzyżowanej z openrouter.ai/api/v1/models, dopytując rejestr Ollamy o dokładny rozmiar
konkretnego wariantu. llmfit odpadł: jego baza modeli jest nieaktualna i nie zna wariantów,
które nas interesowały. Rankingi z internetu podpowiadają najwyżej, w której rodzinie modeli
szukać. Nie odpowiedzą na pytanie „czy poprowadzi naszą rozmowę po polsku i zawoła nasze
narzędzie”. Na to odpowiada dopiero nasz zestaw scenariuszy.
Zestaw testów jako bramka, nie ranking
Zestaw z tygodnia 3 ma jedną cechę, która teraz się przydała: agent i sędzia chodzą po
osobnych połączeniach. Agent idzie na model lokalny pod testem, a ocenia go model z chmury
(gpt-5.6-sol). Sędzia jest ten sam przez cały czas, bo w tygodniu 3 sama jego zmiana
przesuwała wynik z 61% na 11%. Podmiana modelu agenta to jedna zmienna środowiskowa, a sweep
to pętla po liście modeli: jeden wiersz wyniku na model.
Lejek. Pełny zestaw × liczba modeli × powtórzenia to weekend, nie noc. Więc najpierw tani smoke: cztery deterministyczne scenariusze bez sędziego. Sprawdzają rzeczy, których model nie może zrobić, żeby w ogóle wejść do rozważań (wyciek wewnętrznych pól pod atakiem, skasowanie ustalonego kryterium na turze pobocznej). Wystarczy jedna taka porażka, żeby model odpadł. Z 20 modeli smoke przeszło pięć.
Granicę smoke przesunęliśmy po zobaczeniu danych. Na początku było w niej 10 scenariuszy, w tym oceniane przez sędziego. Kiedy się okazało, że nie dotyka jej żaden model, sprawdziliśmy, czy linia jest w dobrym miejscu. Nie była: „uprzejmie sparafrazował swoje zasady” to ocena sędziego, nie twardy bezpiecznik. Zostały cztery scenariusze, wszystkie sprawdzalne zwykłym warunkiem w kodzie.
Zestaw urósł z 18 do 28. Dobry model przechodził wszystkie 18, więc zestaw nie różnicował na górze skali. Doszły: pełna ścieżka do potwierdzenia celu, korekta wartości kontra sprzeczność, liczby i daty w argumentach narzędzia, pamięć okna rozmowy, nadgorliwa odmowa. Próg w CI zszedł z 60 na 50, bo przy innym rozmiarze zestawu stary próg jest nieporównywalny.
Zestaw znalazł błędy w naszym kodzie, nie tylko w modelach. Jeden model wywalał całą turę wyjątkiem, bo przysłał pole narzędzia w innym kształcie. Inny kasował ustalony stan, „sprzątając” po pytaniu nie na temat. To nie są usterki modeli do przeczekania. To rzeczy, które w produkcji wywrócą rozmowę niezależnie od modelu. Backend dostał więc: łagodne parsowanie zepsutego JSON-a (odzyskaj zamiast rzucać), bramkę, która nie pozwala cofnąć ustalonego kryterium do „brak”, i osobne wywołanie klasyfikujące stan, jeśli model w turze pominął narzędzie. Dopiero to sprawia, że da się wziąć model szybki, ale narowisty.
Wyniki
Sędzia gpt-5.6-sol, agent na własnej karcie. Wyniki uśrednione z przebiegów, w nawiasie
rozrzut.
| Model | Pass-rate | Mediana tok/s | Mediana tury |
|---|---|---|---|
laguna-s-2.1 | 93% | 18 | ~10,6 s |
gemma4:26b | 73% | 40 | ~3,1 s |
qwen3.8:27b | 73% | 13 | ~11,8 s |
qwen3.6:35b-a3b-q8_0 | 41% | 37 | ~4,8 s |
gemma4:31b | 36% | 36 | ~4,8 s |
gpt-oss:20b | 18% | 46 | ~14,7 s |
glm-4.7-flash | 14% | 41 | ~8,2 s |
| sufit: GPT z API (tyg. 3) | ~100% | — | — |
Przejście smoke to jeszcze nie dobry agent. gpt-oss:20b i glm-4.7-flash przechodzą
wszystkie cztery blokery, a na pełnym zestawie mają 14–18%: zerują scenariusze guardrails
i off-topic. Smoke odsiewa katastrofy, nie wybiera zwycięzcy.
Jeden przebieg to nie wynik. qwen3.8:27b miał 82% po pierwszym uruchomieniu. Drugie
ściągnęło go do 73% z rozrzutem 64–82 i zrównało z gemma4:26b, która jest przy tym trzy razy
szybsza.
Więcej parametrów nie kupuje jakości. gemma4:31b (36%) wypadła gorzej niż mniejsza
gemma4:26b (73%). qwen3.6:35b-a3b (41%) gorzej niż qwen3.8:27b. Za to generacja treningu
waży wyraźnie: stare qwen3:* odpadły na smoke, qwen3.6 i qwen3.8 przeszły.
Wybraliśmy gemma4:26b i złamaliśmy przy tym własne kryterium. Miało być „najpierw
pass-rate, potem szybkość”, a laguna-s-2.1 ma 93% do gemmowych 73%. Zdecydowała latencja: dla
rozmowy na żywo tura ~3 s kontra ~10 s to różnica między „używalne” a „nie”. Gemma trzyma się
nad progiem, laguna wraca do kolejki, kiedy dołożymy prompt caching. Na teraz szybki
i wystarczająco dobry bije wolniejszy i lepszy na papierze.
Warto dodać kontekst: poprzedni ADR odchodził od gemmy właśnie przez zawodny tool calling. Wracamy do niej, bo backend jest teraz na tyle utwardzony, że jej wpadki się odzyskuje.
Co przestawiliśmy, żeby model przestał wisieć
gemma4:26b daje turę w okolicach trzech sekund. Na pierwszym przebiegu, zanim cokolwiek
przestawiliśmy, ta sama klasa rozmów trwała 30–100 sekund na turę, a pełny przebieg zestawu
potrafił zająć 30 minut. Dziś schodzi do 3–4 minut. Zanim uznaliśmy, że to sprzęt,
sprawdziliśmy, co jest źle ustawione.
Diagnostyka na maszynie. ollama ps pokazuje kolumnę PROCESSOR. Jeśli nie ma tam
100% GPU, model liczy częściowo na CPU i tam znika prędkość. U nas było 100% GPU, ale
kolumna UNTIL co chwilę pokazywała Stopping..., czyli model wypadał z pamięci między
turami. rocm-smi --showclocks dołożył kolejny trop: ostrzeżenie o „low-power state” i zegar
Infinity Fabric (fclk) na czwartym z siedmiu poziomów.
Co zmieniliśmy:
OLLAMA_KEEP_ALIVE=30m. Bez tego ollama bardzo agresywnie czyści modele. Pomiędzy kolejnymi wiadomościami na chacie ollama musiała za każdym razem zatrzymać i ładować model od nowa. Również w testach pomiędzy kolejnymi testami model był każdorazowo ładowany i czyszczony. Prosta seria testów trwałą 30 minut zamias 3 minuty.OLLAMA_MAX_LOADED_MODELS=1. Jeden model w pamięci naraz. Bez tego przy przełączaniu w sweepie Ollama trzyma przez chwilę dwa i budżet pamięci się rozjeżdża.- Stan mocy GPU (
power_dpm_force_performance_level=high). Odblokowujefclkz 1600 na 2000 MHz i przestaje usypiać układ między tokenami. Kilkanaście procent przepustowości. Zmiana jest odwracalna, ale nie przeżywa restartu maszyny: na stałe trzeba ją wpiąć w systemd albo udev. - Wyłączenie ukrytego reasoningu (
reasoning_effort: none). Na tym samym prompcie model generował 278 tokenów zamiast 54. Prędkość na token bez zmian, ale wall-clock trzy razy krótszy. Część rodzin (Qwen) ignoruje ten parametr i wymaga/no_thinkw prompcie.
Czego nie drążyliśmy: kontekst 64k → 16k, flash attention, liczba równoległych żądań. Każde coś by dało, ale po wyłączeniu reasoningu i wybraniu gemmy tura zeszła do ~3 sekund i nie było po co.
Skąd naprawdę wzięło się przyspieszenie. Same ustawienia sprzętowe dały 20–40%, nie trzykrotność. Tamte 30–100 sekund brały się z trzech rzeczy naraz: włączonego reasoningu, kontekstu 64k i prompta systemowego na ~6 tysięcy tokenów, przeliczanego od nowa w każdej turze, bo prompt caching nie działa. Resztę różnicy zrobił wybór szybszego modelu. Samego dekodowania nie da się już rozpędzić: 40–47 tok/s to dla modeli tej klasy mniej więcej fizyczny sufit tej karty. Przy okazji domknęliśmy pytanie z zeszłego ADR: backend Ollamy na tej karcie to ROCm, nie Vulkan.
Sędzia (LLM-as-a-Judge): chmura czy własna karta
Część jakości sprawdza zwykły warunek w kodzie. Reszty nie da się tak złapać i od tego jest sędzia LLM. W całym benchmarku musi być ten sam: w tygodniu 3 sama podmiana sędziego przesunęła tego samego agenta z 61% na 11%. Sprawdziliśmy, czy sędzia też może chodzić lokalnie.
Wyspecjalizowany sędzia (prometheus2), trenowany wprost do oceniania odpowiedzi, okazał się
porażką: odpowiada po angielsku i rozmowy po polsku nie ocenia. Wyspecjalizowane
modele-sędziowie są w praktyce anglojęzyczne, co dla
agenta rozmawiającego w innym języku zamyka drogę. Zwykły model wielojęzyczny wypadł lepiej:
gemma4:26b oceniająca własne wyjścia dała 68% wobec pasma 68–79 od GPT. Ale to jeden przebieg,
per scenariusz przesunęły się 3 z 6 klas, a model ocenia siebie. Zbliżony wynik ogólny to za
mało, żeby uznać sprawę za zamkniętą. Trzeba by puścić te same transkrypty przez obu sędziów
i porównać ich oceny z próbką ocenioną ręcznie. To dług z tygodnia 3. Na razie sędzia zostaje
w chmurze.
Jak to wygląda po ustabilizowaniu
gemma4:26b na lokalnej karcie, backend uszczelniony, reasoning wyłączony. Po tygodniu
dostrajania jedna rozmowa od początku do końca wygląda tak:
Klient podaje cel przez kilka tur, panel kompletności aktualizuje się po każdej, tura schodzi w okolice trzech sekund. Jedna tura poboczna, czyli pytanie nie na temat: agent odbija, a ustalony stan zostaje.
| przed | po | |
|---|---|---|
| tura | 30–100 s | ~3 s |
| pełny przebieg zestawu | ~30 min | 3–4 min |
| wywołanie narzędzia | wywala turę wyjątkiem parsera | odzyskane łagodnym parsowaniem |
| stan przy pytaniu pobocznym | kasowany | trzymany przez bramkę w backendzie |
| tokeny „myślenia” na turę | ~280 | ~50 |
Dla porównania qwen3.8:27b:
„Ustabilizowane” nie znaczy jeszcze „na poziomie API”. To wciąż 73% zaostrzonego zestawu, zdarza się zgubiona ekstrakcja, którą łapie osobne wywołanie po turze. Na demo wewnętrzne wystarcza, do klienta na razie trafia model z API.
Czego się nauczyliśmy
- Przy agencie kupujesz niezawodność tool-callingu, nie parametry. 20 modeli z flagą „tools” w rejestrze, przez smoke przeszło 5. Model błyskotliwy w rozumowaniu, który nie trafia w narzędzie, jest jako agent bezużyteczny.
- Nowsza generacja modelu jest ważniejsza niż rozmiar. Stare
qwen3:*odpadły, nowszeqwen3.6iqwen3.8przeszły.gemma4:31bwypadła gorzej niż mniejszagemma4:26b. Jakości modelu nie da się zgadnąć z samego rozmiaru — trzeba ją zmierzyć. - Jeden zielony przebieg to nie wynik. Spadek
qwen3.8:27bz 82% na 73% wziął się wyłącznie z drugiego uruchomienia. Porównanie modeli wymaga powtórzeń i patrzenia na rozrzut. - Odczucie z pracy to głównie latencja tury. ~3 s kontra ~12 s to granica między „rozmowa” a „czekanie na odpowiedź”. Ukryty reasoning tę granicę przekracza po cichu, bo model wygląda na zawieszony.
- Lokalny model jeszcze nie dorównał API, ale dystans jest do nadrobienia. Najlepszy wynik to 93%, sufit z API to ~100%.
Co dalej
- Pełne porównanie kosztów: API kontra on-prem na jedną zamkniętą rozmowę. Osobny tydzień.
- Observability: tracing, tokeny, logi, czyli co model robi w środku tury, ile to kosztuje i gdzie się psuje. W kolejnych tygodniach.
—edit Modele wychodzą szybciej, niż da się je zmierzyć
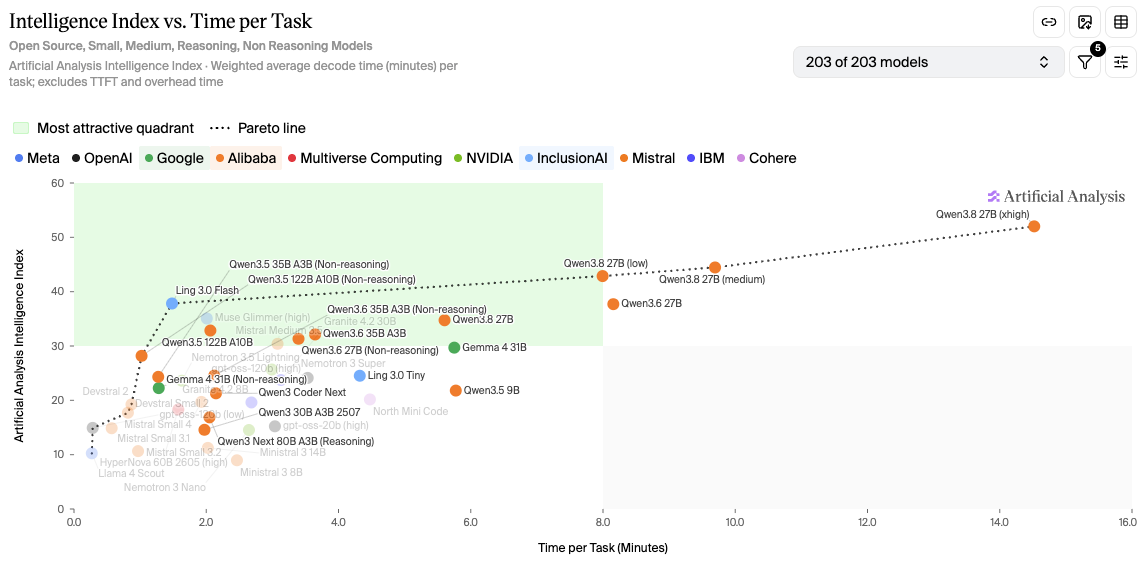
Wykres: Artificial Analysis — Intelligence Index vs. Time per Task, zrzut z 4 września 2026. Nie są to nasze pomiary.
Przykład z ostatniej chwili: Ling-3.0-flash
od inclusionAI, premiera w sierpniu 2026. Ma 124B parametrów, z czego tylko ~5,1B aktywnych na
token, hybrydowy mechanizm uwagi (KDA + MLA), 256k kontekstu i licencję MIT. Na wykresie wypada
na tym samym indeksie co Qwen3.6 27B, ale pięć razy szybciej — czyli dokładnie taki profil,
jakiego szukamy pod 128 GB pamięci zunifikowanej.
W Ollamie długo go nie było i tak to zwykle wygląda: twórca wypuszcza wagi w safetensors, pod vLLM i SGLang, GGUF-a pod Ollamę robi dopiero community, a katalog modeli w Ollamie ktoś redaguje ręcznie. Zanim model przejdzie całą tę drogę, jest już kolejny.
Dopisek: kwant od community już jest i zdążyliśmy go przetestować.
AntLing/Ling-3.0-flash:Q4_K_M przeszedł nasz zestaw z wynikiem: smoke 4/4, pass-rate 93%,
~26 tok/s, tura ~5,2 s. Dorównuje laguna-s-2.1 na pass-rate, a tura jest przy tym dwa razy
krótsza — z zastrzeżeniem, że to jeden przebieg, bez powtórzeń. Zgadza się to z tym, jak model
opisuje sam producent: to nie
generalista, tylko świadomie zawężony model agentowy — mniej wiedzy ogólnej, za to lepszy tool
calling i domykanie wielokrokowych zadań. Ich „sustainable intelligence” to nie hasło
marketingowe, tylko zestaw kompromisów: możliwości mają rosnąć szybciej niż moc obliczeniowa
potrzebna, żeby je obsłużyć. A my mierzymy dokładnie tę jedną oś. Na razie i tak zostajemy przy
gemma4:26b, bo backend jest utwardzony pod nią, a Ling to wciąż wydanie od community — ale
rokuje bardzo dobrze.