Firma wdraża asystenta AI do obsługi klientów. Pierwsze pytania idą gładko, model odpowiada płynnie, uprzejmie i konkretnie. Dopiero przy piątym pytaniu ktoś dopytuje o promocję, która skończyła się miesiąc temu. Asystent odpowiada, że wciąż trwa. Z pełnym przekonaniem.
Model językowy nie weryfikuje automatycznie faktów, po prostu przewiduje, jakie słowa najprawdopodobniej powinny paść jako następne. Gdy brakuje mu informacji, może więc wygenerować płynną, wiarygodnie brzmiącą i czasem po prostu nieprawdziwą odpowiedź. Żadne polecenie nie dostarczy modelowi informacji, których nie ma.
Sam model nie ma też automatycznego dostępu do aktualnego stanu firmy: nowego cennika, zmienionej procedury czy wewnętrznej dokumentacji.
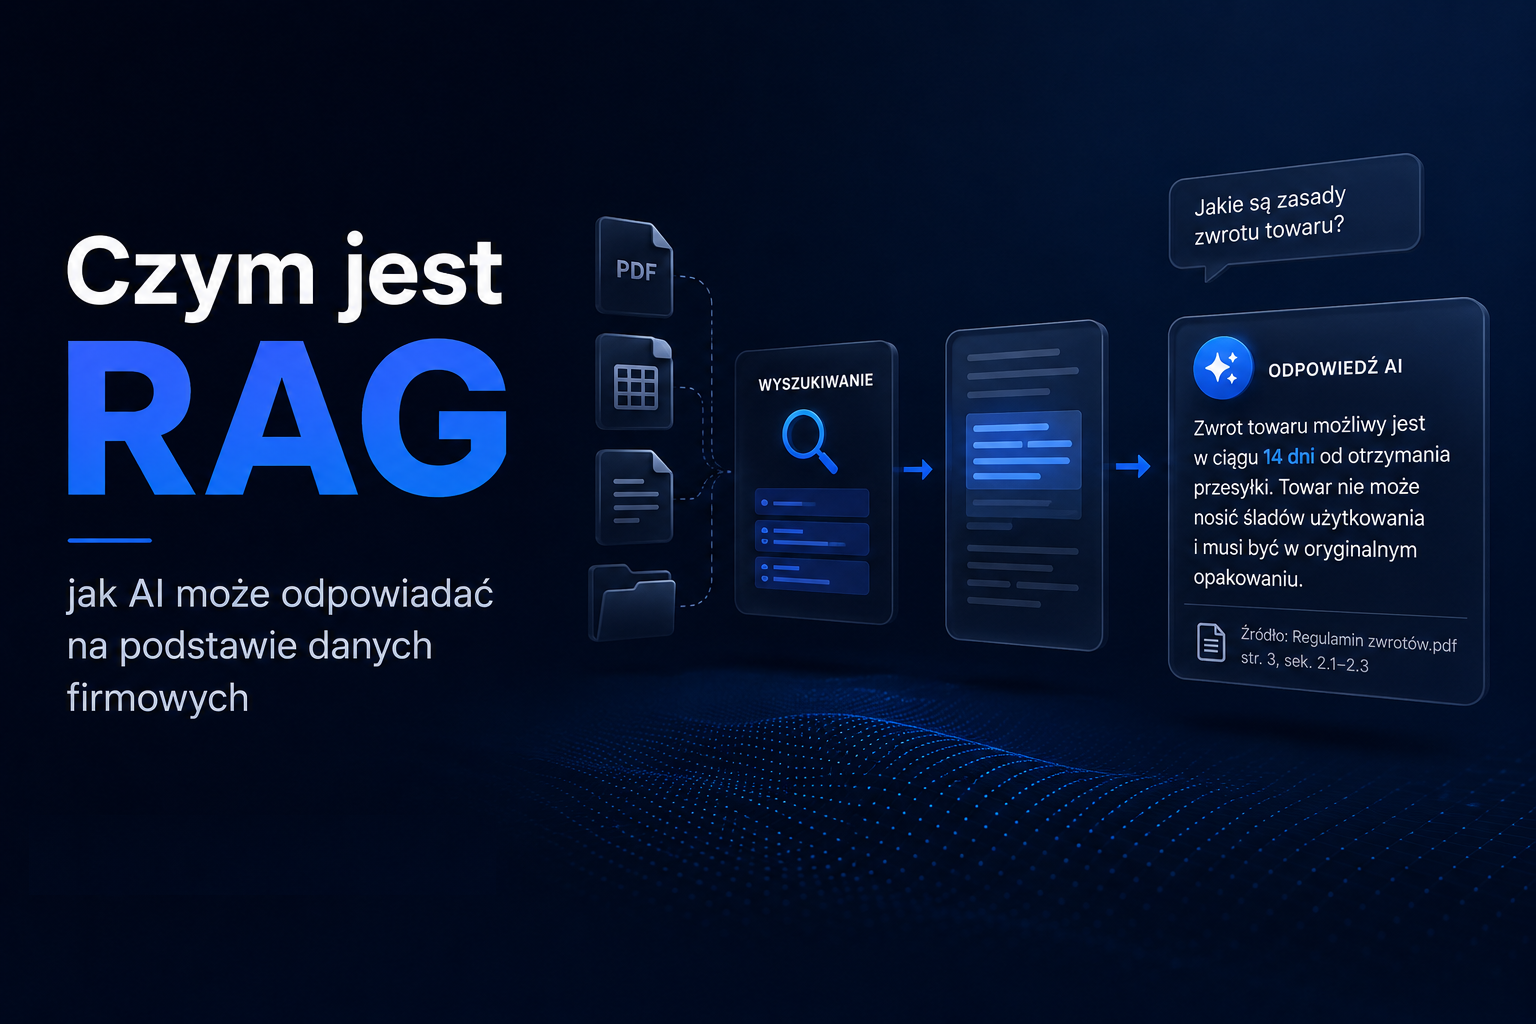
RAG, czyli Retrieval-Augmented Generation, to jedna z technik dostarczania modelowi dodatkowych informacji wtedy, kiedy są potrzebne. Najlepiej sprawdza się, gdy trzeba odnaleźć właściwą wiedzę w zbiorze dokumentów lub innych treści.
Czym jest RAG
Najprostsza analogia: wyobraźcie sobie eksperta, który świetnie analizuje informacje, ale przed odpowiedzią musi dostać materiały źródłowe. Ktoś wyszukuje mu w dokumentach kilka najistotniejszych fragmentów i dopiero wtedy ekspert odpowiada.
System wykonuje trzy podstawowe kroki:
- Wyszukuje (Retrieval) informacje, najbardziej pasujące do pytania, pochodzące z bazy wiedzy przygotowanej wcześniej: dokumenty trzeba pobrać, podzielić na fragmenty i zaindeksować. Może używać wyszukiwania semantycznego, czyli po znaczeniu, a nie po dokładnych słowach - klasycznego wyszukiwania po słowach albo obu metod jednocześnie.
- Dołącza znalezione fragmenty do pytania użytkownika i przekazuje całość modelowi, stąd „wzbogacone” (Augmented) w nazwie.
- Generuje odpowiedź (Generation), wykorzystując dostarczone fragmenty jako źródło wiedzy.
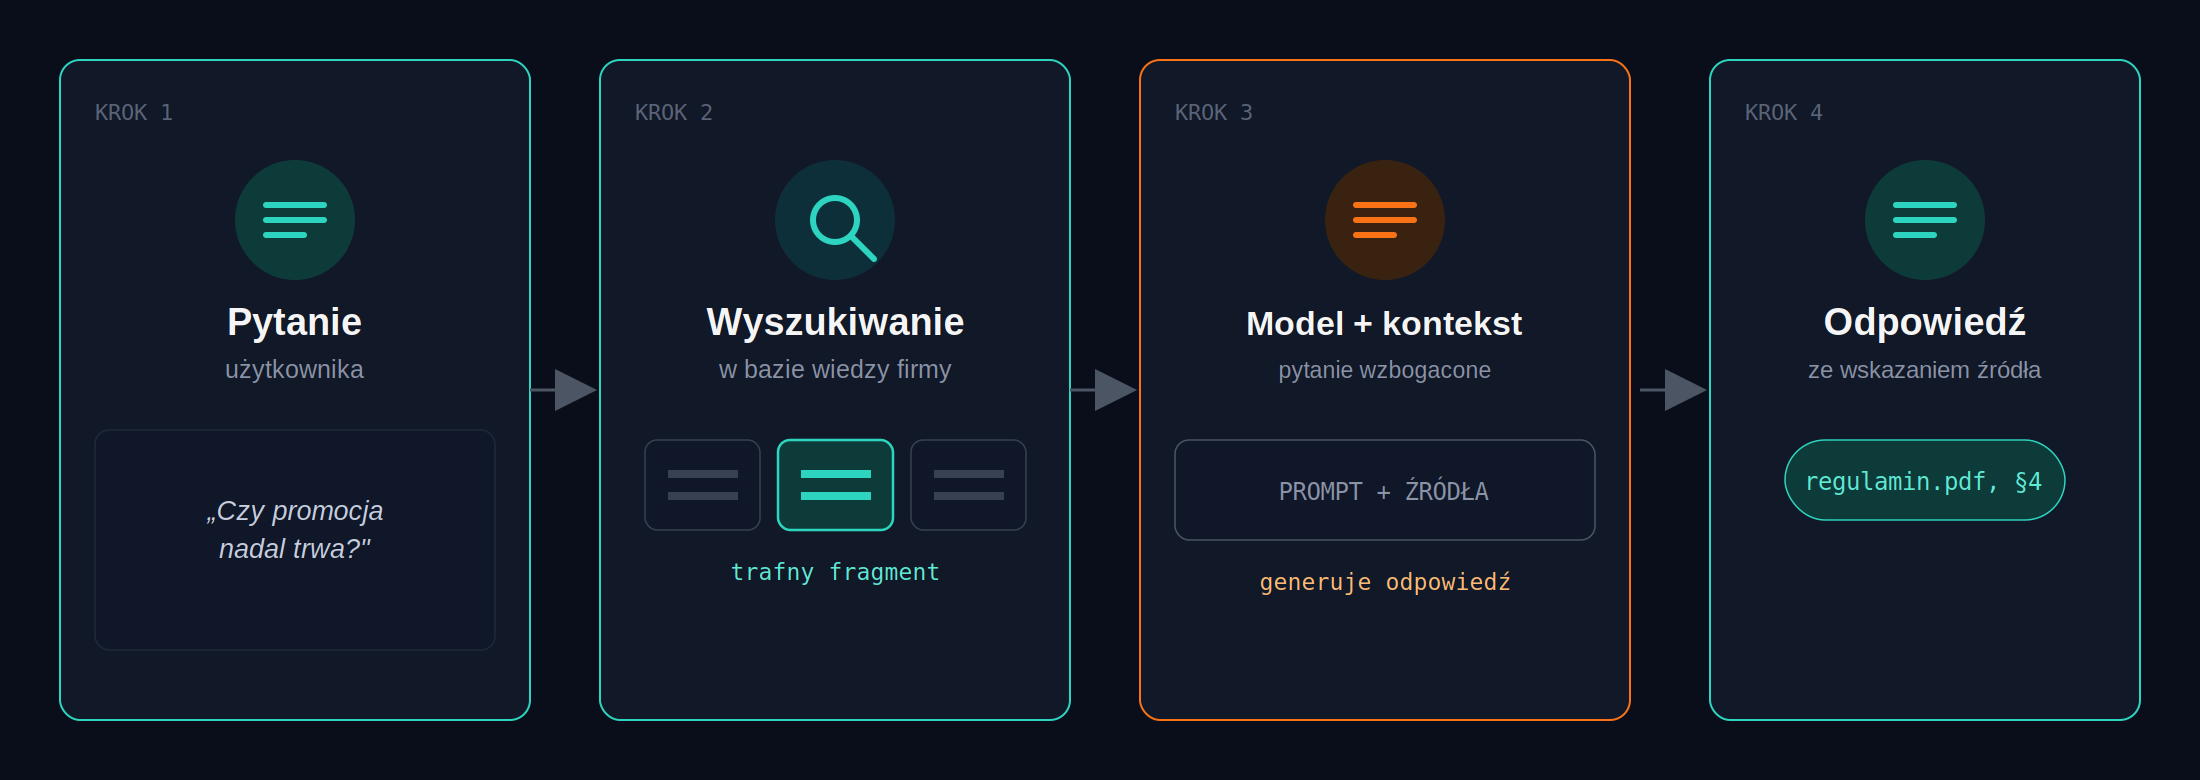
W prostszych systemach wyszukiwanie uruchamia się przy każdym pytaniu; w bardziej rozbudowanych to model decyduje, czy i czego szukać.
Asystent z początku tego tekstu dostałby w ten sposób aktualny regulamin promocji i informację, że promocja się skończyła. Dobrze zaprojektowany system wskaże przy tym dokument i fragment, na którym oparł odpowiedź, dzięki czemu użytkownik może ją zweryfikować.
RAG nie jest fine-tuningiem. Fine-tuning służy przede wszystkim do kształtowania sposobu działania modelu, a RAG dostarcza mu aktualną wiedzę ze wskazanych źródeł. Oba podejścia mogą się uzupełniać, ale rozwiązują inne problemy.
Do czego RAG realnie się przydaje
Najbardziej naturalne zastosowania pojawiają się tam, gdzie odpowiedź musi oprzeć się na wiedzy zapisanej w firmowych treściach:
- Wewnętrzna baza wiedzy — pracownik pyta o procedurę, zamiast ręcznie przeszukiwać intranet czy katalog dokumentów.
- Obsługa klienta — asystent wyjaśnia aktualny cennik, regulamin, dokumentację produktu lub zasady zwrotu na podstawie właściwych źródeł.
- Dokumentacja techniczna — system odpowiada na pytanie na podstawie setek stron instrukcji i wskazuje źródło.
- Dokumenty prawne i procedury — RAG pomaga odnaleźć właściwe zapisy w umowach, regulaminach i politykach wewnętrznych.
Nie zastępuje natomiast systemów, które przechowują bieżący stan firmy.
RAG to nie jedyny sposób pracy z danymi firmowymi
W firmowym systemie AI różne informacje wymagają różnych mechanizmów. RAG nie jest domyślnym sposobem pobierania bieżącego stanu z systemu biznesowego.
Jeśli użytkownik pyta: „Jak wygląda procedura zwrotu?”, asystent może wyszukać odpowiedni regulamin i wyjaśnić go na podstawie źródła. To naturalne zastosowanie RAG-u.
Jeśli pyta: „Gdzie jest moje zamówienie nr 123?”, potrzebny jest aktualny rekord z systemu zamówień - asystent powinien sięgnąć po integrację, która zwróci status tego konkretnego zamówienia. Wyszukanie podobnego tekstu w dokumentach nie zapewni ani aktualności, ani pewności, że dane dotyczą właściwej osoby.
Ta sama zasada obejmuje stan magazynowy, saldo klienta, cenę wyliczoną dla konkretnego konta czy rezerwację terminu. Takie zadania wymagają integracji z systemem źródłowym, odpowiednich uprawnień, a przy operacjach zmieniających dane, często również potwierdzenia przed wykonaniem.
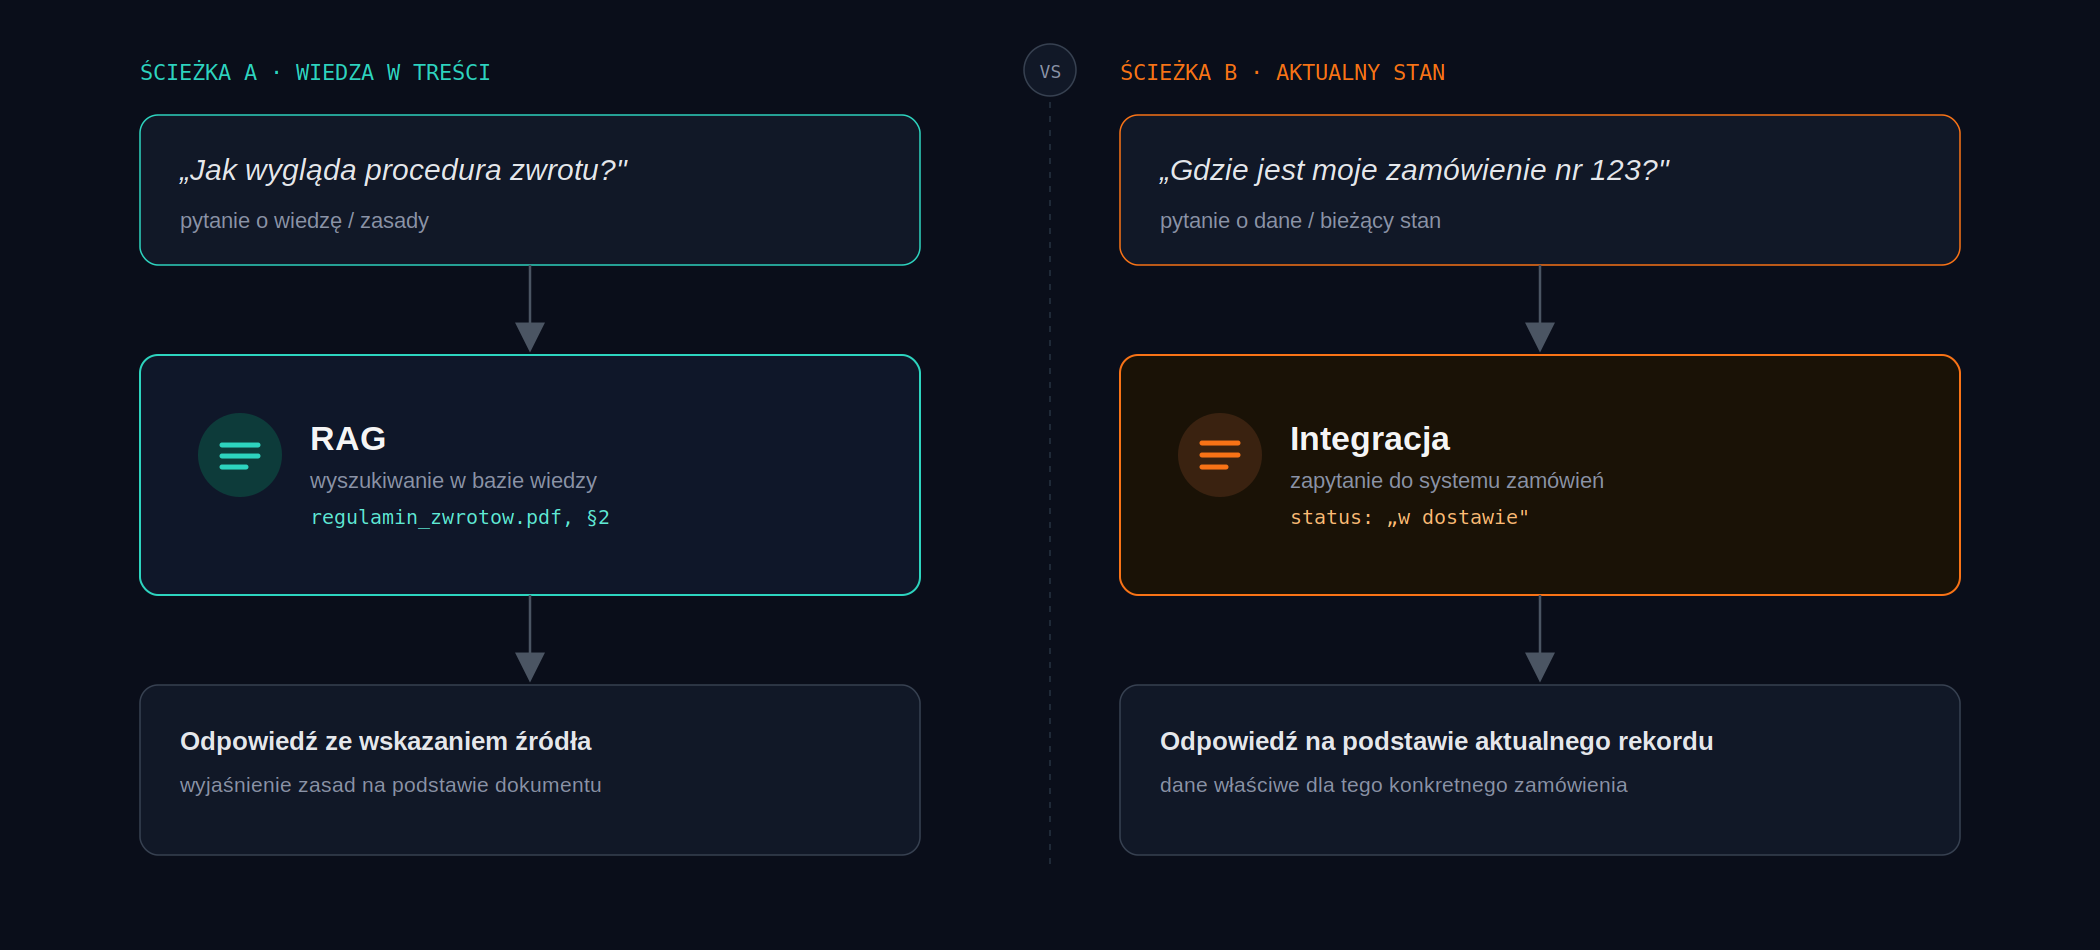
W praktyce oba podejścia współpracują. Ten sam asystent może pobrać status przesyłki z systemu zamówień, a z RAG-u odnaleźć zasady reklamacji i wyjaśnienie, co ten status oznacza.
Najważniejsze pytanie nie brzmi więc: „Czy mamy dane firmowe?”, lecz: „Czy musimy odnaleźć i zinterpretować wiedzę w treści, czy odczytać aktualny stan albo wykonać działanie w systemie?”
RAG nie eliminuje halucynacji
Warto od razu ostudzić jedno oczekiwanie. RAG ogranicza jeden z głównych powodów błędnych odpowiedzi - brak właściwych informacji w kontekście, ale nie sprawia, że model przestaje się mylić. System może znaleźć niewłaściwy dokument, pominąć istotny fragment albo model może źle zinterpretować poprawnie znalezione informacje, a przypis pod odpowiedzią bywa trafny tylko pozornie, jeśli generuje go sam model, zamiast wskazywać faktycznie pobrane fragmenty.
Dlatego dojrzały system RAG powinien opierać odpowiedź na dostarczonych źródłach, potrafić odmówić odpowiedzi przy braku wystarczających danych i pozwalać sprawdzić, skąd dana informacja pochodzi.
RAG nie usuwa halucynacji, ale daje znacznie lepsze warunki do ich kontrolowania.
Dlaczego wdrożenie RAG to nie „podłącz dokumenty i działa”
Trzy kroki RAG-u brzmią prosto, co może sugerować, że wystarczy wrzucić dokumenty do bazy, podłączyć model i projekt jest skończony. W praktyce właśnie tutaj zaczyna się właściwa praca.
Pierwszy prototyp — dziesięć dobrze przygotowanych dokumentów, kilka przykładowych pytań — działa niemal zawsze i świetnie wygląda na demie. Produkcja z tysiącami dokumentów, wieloma źródłami danych, częstymi aktualizacjami i użytkownikami o różnych poziomach uprawnień to zupełnie inny problem.
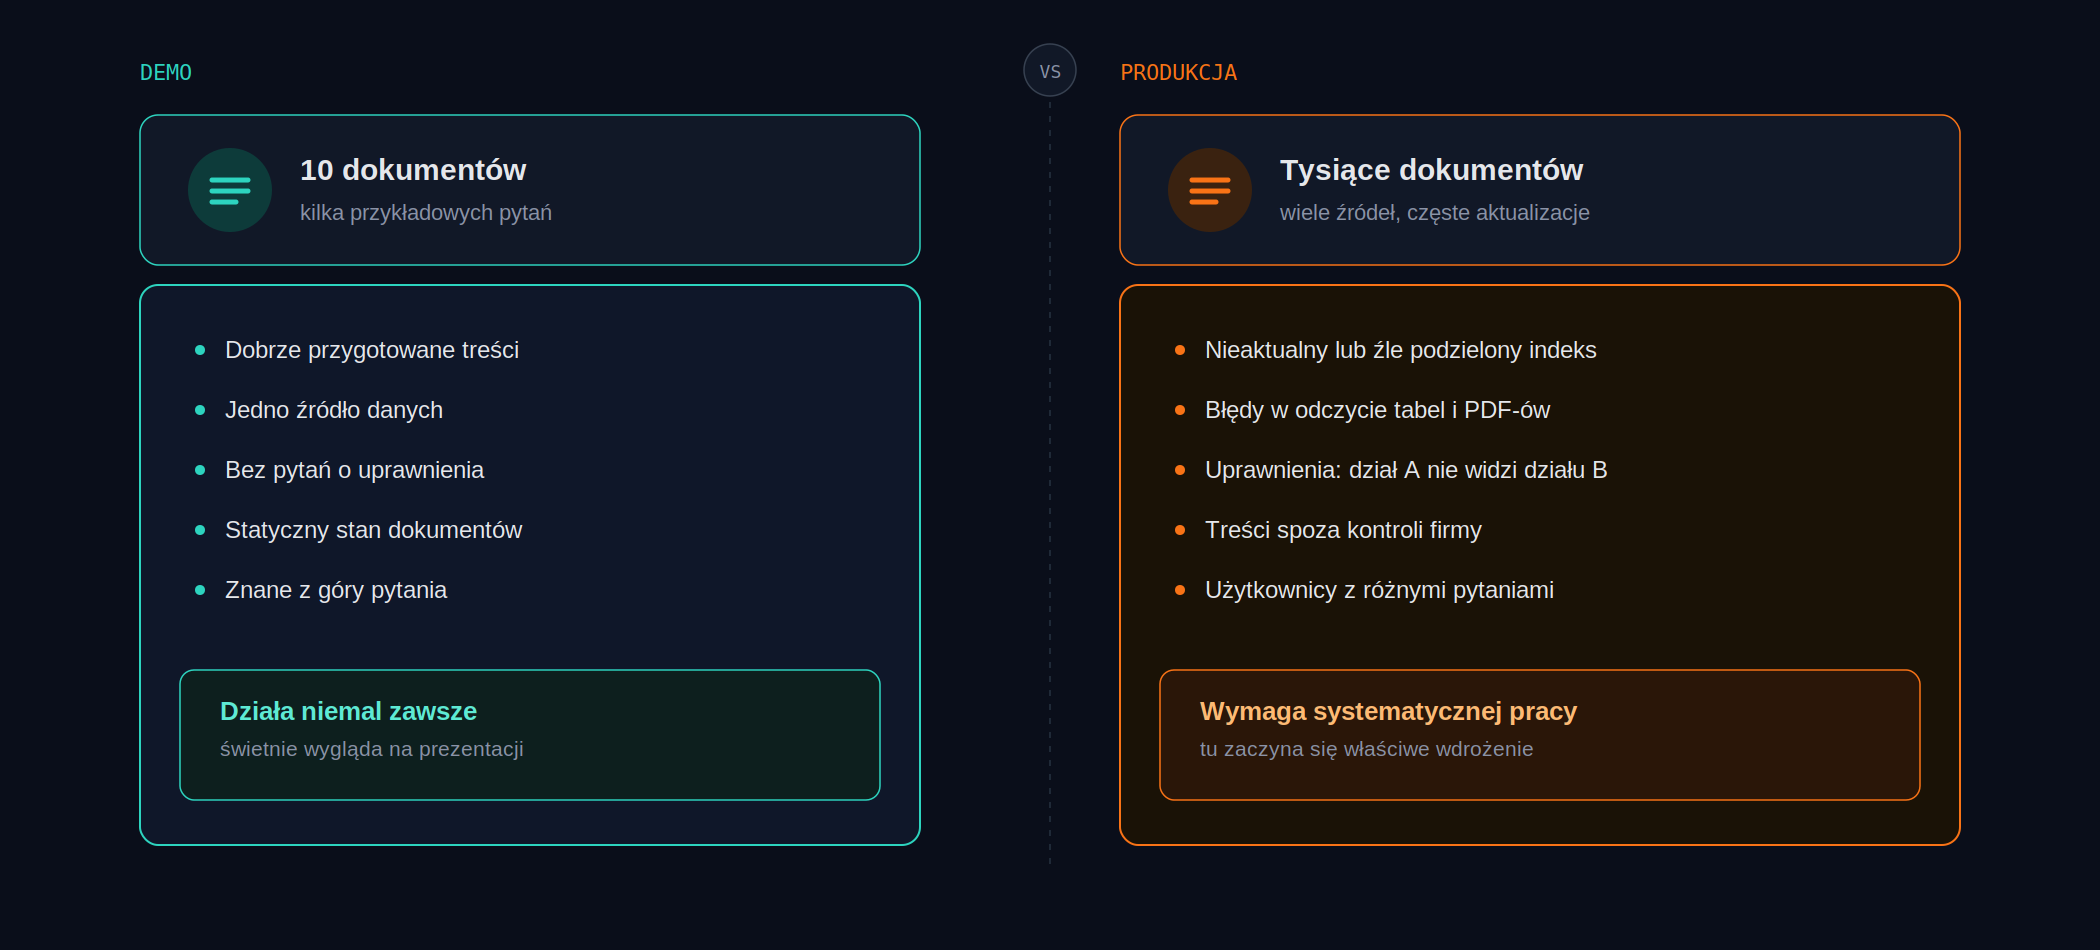
Dokument w indeksie może być nieaktualny, a RAG jest aktualny o tyle, o ile aktualizowany jest indeks. Narzędzie odczytujące plik może błędnie zinterpretować tabelę albo PDF. Treść może zostać źle podzielona na fragmenty. Wyszukiwarka może znaleźć tekst podobny językowo, ale nieodpowiadający na pytanie. System może też zwrócić kilka przeciętnych wyników zamiast jednego właściwego.
Do tego dochodzą uprawnienia. Jeżeli pracownik działu A nie ma dostępu do dokumentów działu B, asystent AI również nie może ich użyć do wygenerowania odpowiedzi. Osobna sprawa to treści, nad którymi firma nie ma pełnej kontroli: zgłoszenia klientów, pliki od kontrahentów, strony internetowe. Ukryta w dokumencie instrukcja potrafi wpłynąć na zachowanie asystenta. Kontrola dostępu i zaufanie do źródeł nie są dodatkiem do RAG-u, w systemie firmowym są jednym z jego podstawowych wymagań.
Największym problemem często nie jest model
Gdy odpowiedzi są słabe, naturalną reakcją jest zmiana modelu na większy. Czasami pomaga, ale bardzo często większą poprawę daje lepsze przygotowanie dokumentów, inny sposób ich podziału, połączenie wyszukiwania semantycznego z klasycznym albo ponowne uszeregowanie znalezionych fragmentów według trafności (tzw. reranking).
Dlatego przy diagnozowaniu jakości warto rozdzielić dwa pytania:
- Czy system znalazł właściwe informacje?
- Czy model poprawnie je wykorzystał?
Jeśli wyszukiwanie zwróciło zły dokument, nawet świetny model ma ograniczone możliwości. Jeśli zwróciło właściwy, a odpowiedź nadal jest błędna, przyczyna leży zwykle w instrukcji dla modelu, w źle przyciętym fragmencie albo w sprzecznych informacjach w kilku dokumentach. Oba przypadki naprawia się inaczej.
Skąd wiadomo, że RAG działa dobrze
Na demie łatwo uznać, że system „wygląda dobrze”, ponieważ kilka odpowiedzi brzmi sensownie i projekt sprawia wrażenie gotowego. Tyle że „brzmi sensownie” nie jest metryką.
W produkcyjnym RAG-u potrzebna jest ewaluacja: systematyczne sprawdzanie, czy wyszukiwanie znajduje właściwe dokumenty, czy odpowiedź rzeczywiście wynika ze źródeł i czy model potrafi się powstrzymać, gdy odpowiedzi po prostu nie ma w dokumentach.
Trzeba też wiedzieć, czy zmiana modelu, instrukcji dla niego albo sposobu przygotowania dokumentów faktycznie poprawiła wynik. Bez takich testów każda zmiana jest strzałem w ciemno — można poprawić kilka znanych przykładów, jednocześnie psując inne.
Dojrzałe wdrożenie RAG mierzy jakość tak samo systematycznie, jak testuje się każdy inny system produkcyjny.
RAG jest elementem większego rozwiązania
RAG nie jest technologią, którą firma powinna wdrożyć dlatego, że jest popularna. To jeden z elementów pozwalających sensownie wykorzystać modele językowe w istniejących procesach biznesowych, obok integracji systemów, automatyzacji, kontroli dostępu i uporządkowania danych.
Dobrze zaprojektowany asystent dobiera mechanizm do zadania: wyszukuje dokumenty, gdy trzeba dotrzeć do wiedzy, i odczytuje dane z systemu, gdy potrzebny jest aktualny stan. W krytycznych procesach powinien też działać w ramach jasno zdefiniowanych reguł, uprawnień i obsługi wyjątków, w tym możliwości przekazania sprawy człowiekowi.
Dobrze wdrożony RAG potrafi skrócić czas dotarcia do informacji i ograniczyć liczbę odpowiedzi opartych na nieaktualnej wiedzy. Źle wdrożony, bez dbałości o dane, wyszukiwanie, uprawnienia i pomiar jakości — wygląda świetnie na prezentacji i rozpada się przy pierwszym kontakcie z produkcją.
To właśnie odróżnia demonstrację RAG-u od systemu, któremu firma może rzeczywiście zaufać.