PAE (Pragmatic AI Enablement) to nasz wewnętrzny program. Co tydzień jedna osoba bierze jeden temat z AI, ma trzy dni na eksperyment i jeden dzień na opisanie wyników. Pokazujemy fragmenty kodu i pułapki, o których rzadko się pisze.
Agent, którego w programie budujemy, jest doradcą po naszej metodyce PAF, czyli Pragmatic Automation Framework. Rozmawia z klientem o celu automatyzacji i pilnuje, czy padły cztery ustalenia: kto jest sponsorem, co ma się zmienić, jak to się opłaci i na kiedy. Od tygodnia 2 zapisuje je w jawnym stanie, od tygodnia 3 ma testy regresyjne, a w tygodniu 4 wylądował na lokalnym modelu.
Działał. Tylko że ekspert PAF z naszego zespołu po kilku rozmowach opisał go jednym słowem: robotyczny. Ten tydzień był więc w całości o prompt engineeringu: żeby agent rozmawiał o projekcie klienta, a nie odhaczał kolejne punkty, i żeby dało się to zmierzyć, a nie tylko ocenić na oko.
Rozmowa, która przypomina formularz
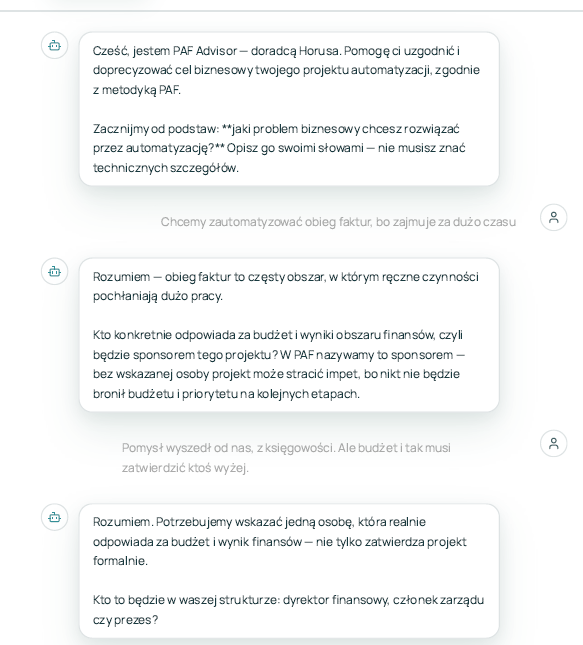
Fragment rozmowy ze starą wersją agenta. Klient wskazał już sponsora i opisał problem z fakturami, teraz przyznaje, że nie zna kosztów:
Klient: Nie mam pojęcia, ile to nas kosztuje. Wszyscy po prostu narzekają.
Agent: Rozumiem. Sam sygnał, że zespół odczuwa problem, nie wystarczy jeszcze do uzasadnienia inwestycji. W PAF nazywamy to mechanizmem i skalą korzyści — bez choćby rzędu wielkości trudno sponsorowi porównać oczekiwany efekt z kosztem projektu i nadać mu priorytet. Czy możecie oszacować choć orientacyjnie, ile godzin miesięcznie księgowość poświęca dziś na ręczny obieg faktur?
Technicznie wszystko jest w porządku: agent rozpoznał brakujący punkt i zapytał o niego. Tyle że klient właśnie usłyszał, że jego odpowiedź jest niewystarczająca, dostał wykład z terminologii i to samo pytanie w nowym opakowaniu.
W całej rozmowie agent użył formułki „W PAF nazywamy to…” w sześciu z dziewięciu odpowiedzi, a trzy zaczął od „Rozumiem.”. O koszt etatu zapytał w czterech kolejnych turach, choć klient mówił już o czymś innym. Panel kompletności na koniec pokazał 100%. Logika działała, rozmowa nie.
Skąd się bierze robotyczny ton
Kiedy przeczytaliśmy prompt pod tym kątem, okazało się, że model robi dokładnie to, czego go uczyliśmy:
- Przykłady uczyły jednego schematu. Każdy przykładowy dialog kończył się pogrubionym pytaniem o brakujące kryterium, a reguła „jedno pytanie naraz” dokładała resztę.
- Formułki do cytowania. Siedem reguł zawierało gotowe zdania, które model odtwarzał słowo w słowo.
- Checklista przed wiadomością klienta. Backend dokleja do każdej tury listę kryteriów i ich statusów, a wiadomość klienta stoi dopiero za nią.
- Instrukcja jako regulamin. Jedna trzecia promptu dotyczyła wywołania narzędzia zapisującego stan i była pisana wielkimi literami. Inna reguła kazała ucinać rozmowę o ludziach i problemach.
- Podpowiedź z kodu. Po każdym zapisie stanu Java zwracała modelowi polecenie „dopytaj o jedno z nich”.
- Gwiazdki na ekranie. Frontend nie renderuje markdownu, więc klient widział każde pogrubienie jako tekst w gwiazdkach.
Żadna z tych rzeczy nie jest błędem osobno. Razem uczą model, że jego zadaniem jest wypełnić formularz.
Jak testować prompt, żeby porównywać wersje
Ocena „brzmi lepiej” to wrażenie, a z wrażeniami mierzyliśmy się już w tygodniu 3. Potrzebowaliśmy porównania jeden do jednego.
Napisaliśmy scenariusz z 11 wiadomości klienta o obiegu faktur, wysyłanych zawsze w tej samej kolejności, niezależnie od tego, o co pytał agent. Są w nim sytuacje, na których stary prompt wypadał najgorzej: ogólnik na start, sponsor wskazany z wahaniem („Pewnie dyrektor finansowa…”), „nie wiem” i przeskok do innego zadania PAF. Po każdej iteracji prowadziliśmy też jedną rozmowę swobodną, bez skryptu, żeby sprawdzić agenta poza przewidywalnym przebiegiem.
Każda wersja to nowa rozmowa na tym samym modelu z API (gpt-5.6-terra), żeby porównywać prompty, a nie modele. W każdym przebiegu liczyliśmy te same rzeczy: formułki i stałe otwarcia, powtórzone pytania, reakcję na „nie wiem”, nawiązania do wcześniejszych wypowiedzi, listy opcji („A, B czy C?”), zdania skopiowane z przykładów, a z logu backendu także tury bez wywołania narzędzia.
Klient ze skryptu jest sztuczny, bo nigdy nie odpowiada na pytania agenta, więc część powtórzonych pytań to efekt metody. Za to każdą zmianę w prompcie widać w tych samych miejscach rozmowy. Z 10 iteracji w tabelach pokazujemy sześć.
Pułapka few-shot: poprawa, która była kopią
W v1 przebudowaliśmy instrukcję. Na początku stanęła sekcja o tym, jak rozmawiać: najpierw odnieś się do słów klienta, daj coś od siebie, pomóż oszacować, gdy klient nie wie. Formułki wyleciały, a przykłady dostały kontrast „tak NIE / tak”.
Efekt był od razu widoczny. Zero formułek, zero „Rozumiem”, a na „nie wiem” agent odpowiedział „To normalne — koszty obiegu faktur rzadko są policzone” i zaproponował, jak je oszacować. Wyglądało to na sukces tygodnia.
Tyle że przykłady w v1 dotyczyły faktur, podobnie jak scenariusz testowy. Przy drugim czytaniu transkryptu znaleźliśmy to:
| Przykład w prompcie | Odpowiedź agenta |
|---|---|
| „Czyli potrzeba jest oddolna, a decyzja zapadnie piętro wyżej.” | „Czyli potrzeba jest oddolna, ale projekt będzie potrzebował osoby, która weźmie odpowiedzialność za budżet i wynik…” |
| „To normalne — rzadko ktoś ma to policzone.” | „To normalne — koszty obiegu faktur rzadko są policzone, dopóki nie pojawi się projekt.” |
W v2 przenieśliśmy przykłady do innych branż i dopisaliśmy, że pokazują sposób myślenia, a nie gotowe zdania. Na tę samą wiadomość agent odpowiedział: „narzekania sygnalizują problem, ale same nie dają jeszcze podstawy do decyzji o inwestycji”. Pouczenie wróciło.
Dobra odpowiedź z v1 nie była zachowaniem modelu, tylko przepisanym przykładem. Gdy temat rozmowy pokrywa się z przykładem, model bierze z niego strukturę i początek zdania, a reguła mówiąca co innego przegrywa. Wniosek dla metody: test na scenariuszu zbieżnym z przykładami zawyża wynik. Od v2 przykłady i scenariusz celowo dotyczą różnych rzeczy.
Każde zdanie w cudzysłowie to szablon
Model kopiował nie tylko przykładowe dialogi. Reguła o niepewnych odpowiedziach podawała wzór „przyjmuję roboczo, że decyduje dyrektor sprzedaży”, więc agent dwa razy w jednej rozmowie zaczął zdanie od „Przyjmuję roboczo, że…”. Opis kryterium sponsora wymieniał typowe stanowiska, więc we wszystkich przebiegach agent pytał „dyrektor finansowy, członek zarządu czy prezes?”. Ten opis nie jest nawet w pliku z promptem, tylko w konfiguracji YAML doklejanej do każdej tury.
W v3 usunęliśmy z reguł wszystkie przykładowe sformułowania i zastąpiliśmy je opisem zachowania.
Warunek działa, przymiotnik nie
Na listy opcji mieliśmy regułę „podawaj je rzadko”. W v3 agent nadal kończył nimi cztery z ośmiu pytań. W v3.1 reguła brzmi: jeśli w poprzedniej odpowiedzi dałeś klientowi opcje, w tej zapytaj otwarcie. Od razu przestał dawać je w dwóch turach z rzędu.
Podobnie z pouczeniem. Zamiast „bądź pomocny” dopisaliśmy: nigdy nie mów ani nie sugeruj, że odpowiedź klienta jest niewystarczająca, i nie chwal jej. Odpowiedź na „nie mam pojęcia, ile to kosztuje” w v3.1:
„To częsta sytuacja — koszt da się oszacować bez pełnej analizy. Przy fakturach najprostszy punkt wyjścia to liczba osób zaangażowanych w obieg i czas, który tygodniowo tracą na przepisywanie danych, przypomnienia oraz szukanie dokumentów. Ilu ludzi w księgowości regularnie zajmuje się tym procesem?”
Model słabo reaguje na przymiotniki („rzadko”, „naturalnie”, „z umiarem”). Dobrze reaguje na warunek, który da się sprawdzić w jednej odpowiedzi.
Reguły oceny należą do definicji kryterium
W v3 klient napisał „Pewnie dyrektor finansowa, to ona najbardziej narzeka na opóźnienia”, a agent od razu zapisał sponsora jako spełnione kryterium. Do końca rozmowy nikt tego nie potwierdził.
Poprawka mogła trafić do promptu rozmowy, ale stan kryteriów ocenia u nas więcej niż jedno wywołanie: agent w rozmowie i zapasowe wywołanie klasyfikujące z tygodnia 4. Oba widzą ten sam opis kryterium z application.yaml, z którego korzystają też testy z tygodnia 3. Tam dopisaliśmy regułę:
- id: sponsor
  label: Sponsor zidentyfikowany
  description: >
    Czy z rozmowy wynika, kto jest sponsorem projektu: konkretna osoba lub rola
    odpowiedzialna za budżet i wynik biznesowy automatyzowanego obszaru? Ogólnikowe
    "zarząd" albo "firma" NIE wystarcza. Wskazanie z zastrzeżeniem klienta ("pewnie",
    "chyba", "raczej") albo osoba wskazana tylko dlatego, że odczuwa problem, bez
    potwierdzenia, że decyduje o budżecie, to najwyżej PARTIAL — SATISFIED dopiero po
    potwierdzeniu przez klienta.
W v3.1 agent zapisał sponsora jako częściowego, powołując się wprost na „pewnie”, a przed podsumowaniem dopytał jednym zdaniem, czy dyrektorka weźmie projekt na swój budżet.
Im swobodniej rozmawia, tym gorzej księguje
Razem z tonem złagodziliśmy sekcję o narzędziu zapisującym stan. W v3 agent pominął wywołanie w czterech z dziewięciu tur, z czego trzy niosły nową informację. Stan i tak był poprawny, bo po turze bez narzędzia backend robi zapasowe wywołanie klasyfikujące.
W v3.1 sekcja o narzędziu znów jest stanowcza. Niezasadne pominięcia spadły do dwóch, potem do jednego w v3.2 i zera w v3.3. Pomijane były zawsze informacje pośrednie („budżet zatwierdza ktoś wyżej”) albo „nie wiem”, a konkretne liczby i nazwiska agent zapisywał niezawodnie. To pojedyncze przebiegi, więc traktujemy to jako trend, nie gwarancję.
Pomogła też zmiana w Javie. Komunikat po zapisie stanu był poleceniem, więc model po każdym wywołaniu wracał do listy braków. Teraz jest informacją:
String guidance = "Informacja dla ciebie, nie polecenie na tę turę. Jeszcze nieustalone:\n" + unresolved
       + "\nNie pisz jeszcze podsumowania końcowego ani propozycji kontaktu z Horusem. "
       + "Najpierw odnieś się do tego, co właśnie powiedział klient; do brakującego punktu "
       + "wróć naturalnie, gdy będzie okazja — niekoniecznie w tej odpowiedzi i nie o ten sam "
       + "punkt, o który pytałeś w poprzedniej.";
Dalszego dokręcania instrukcji nie robiliśmy, bo grozi powrotem robotycznego tonu. Zapasowe wywołanie kosztuje około 1,5 tys. tokenów wobec 8,5 tys. w głównym. To argument za rozwiązaniem architektonicznym: ekstrakcja stanu jako osobne wywołanie, a prompt rozmowy bez sekcji o narzędziu.
Tura bez pytania i koniec bez zmyślania
W v3.2 propozycja sesji z ekspertem trafiła tam, gdzie powinna: po potwierdzeniu podsumowania przez klienta. Przebieg odsłonił jednak dwa nowe problemy.
To samo pytanie trzy razy. O to, czy dyrektorka zatwierdza budżet, agent zapytał w trzech kolejnych turach, za każdym razem innymi słowami. Zakaz pytania dwa razy o to samo był w prompcie, ale model obchodził go parafrazą. Robił to, bo każda odpowiedź musiała kończyć się pytaniem, a innego tematu już nie miał.
Wymyślony szczegół. Na „tak, chętnie” agent odpisał, że na horus.pl klient „wybierze dogodny termin”. Prompt kazał tylko odesłać na stronę. O kalendarzu agent nic nie wiedział, więc dopowiedział coś, co brzmi wiarygodnie.
W v3.3 zakaz powtórzeń obejmuje też parafrazy, a prompt wprost pozwala zakończyć turę bez pytania. Przy umawianiu sesji agent ma nie dopowiadać niczego, czego nie wie. Efekt: do budżetu wrócił raz, jednym zdaniem bez pytajnika, a na „tak, chętnie” odpowiedział krótko: „Dziękuję. Sesję umówisz przez stronę horus.pl.”
Wyniki
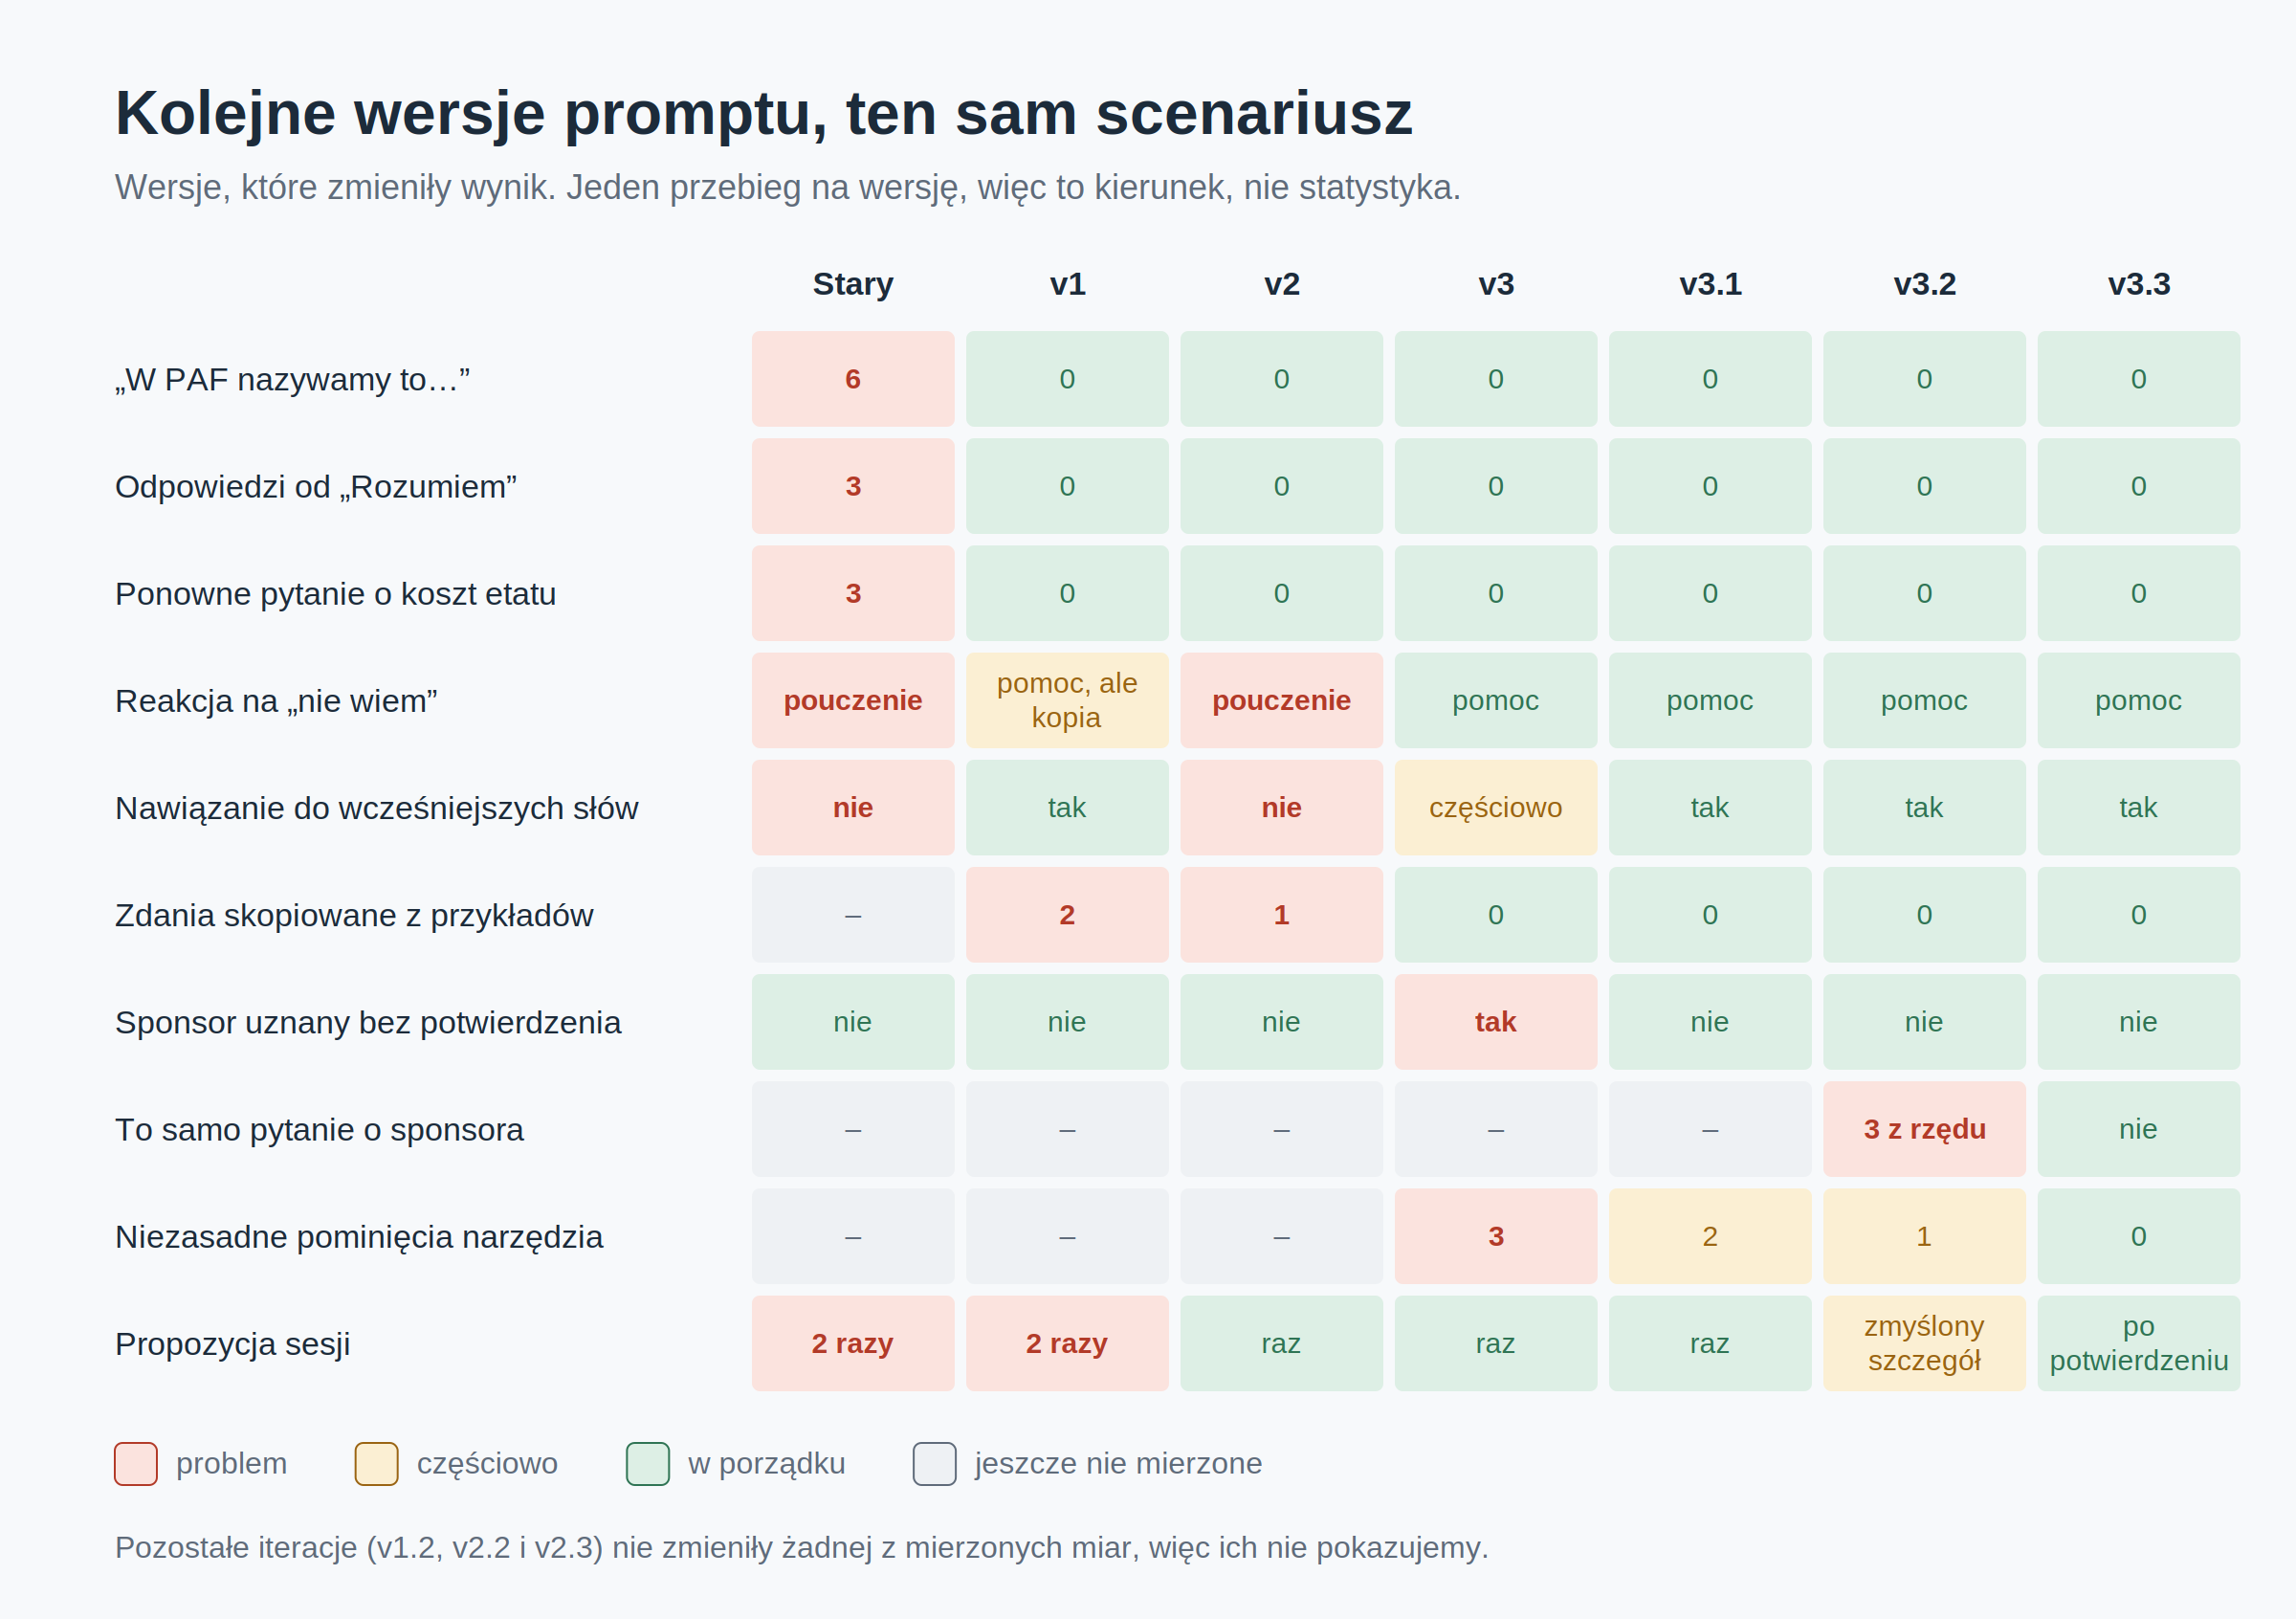
| Miara | Stary | v1 | v2 | v3 | v3.1 | v3.2 | v3.3 |
|---|---|---|---|---|---|---|---|
| „W PAF nazywamy to…” | 6 | 0 | 0 | 0 | 0 | 0 | 0 |
| Odpowiedzi od „Rozumiem” | 3 | 0 | 0 | 0 | 0 | 0 | 0 |
| Pytanie o koszt etatu zadane ponownie | 3 | 0 | 0 | 0 | 0 | 0 | 0 |
| Reakcja na „nie wiem” | pouczenie | pomoc (kopia przykładu) | pouczenie | pomoc | pomoc | pomoc | pomoc |
| Nawiązanie przy przeskoku do interesariuszy | nie | tak | nie | częściowo | tak | tak | tak |
| Zdania skopiowane z przykładów | – | 2 | 1 | 0 | 0 | 0 | 0 |
| Sponsor uznany bez potwierdzenia | nie | nie | nie | tak | nie | nie | nie |
| Pytanie o sponsora w kolejnych turach | – | – | – | – | – | 3 z rzędu | nie |
| Niezasadne pominięcia narzędzia | – | – | – | 3 | 2 | 1 | 0 |
| Propozycja sesji | 2 razy | 2 razy | raz | raz | raz | raz, po potwierdzeniu (zmyślony szczegół) | raz, po potwierdzeniu |
„–” oznacza, że w tej wersji jeszcze tego nie liczyliśmy. Każda kolumna to jeden przebieg jednego scenariusza, więc tabela pokazuje kierunek, nie statystykę.
Ta sama wiadomość klienta przed i po:
| Klient: „Nie mam pojęcia, ile to nas kosztuje” | |
|---|---|
| Stary prompt | „Rozumiem. Sam sygnał, że zespół odczuwa problem, nie wystarczy jeszcze do uzasadnienia inwestycji.” |
| v3.3 | „To częste przy obiegu faktur — koszt jest rozproszony między księgowością, osobami akceptującymi i opóźnieniami w samym księgowaniu. Możemy zacząć od prostego przybliżenia…” |
Agent dokłada też coś od siebie. Po podaniu kosztu etatu stary prompt wracał do sponsora z formułką PAF. v3.3 przeliczył półtora etatu na około 180 tys. zł rocznie i dodał, że nie cały ten koszt musi zniknąć, ale pokazuje skalę możliwych oszczędności. A instrukcja v3.3 jest odrobinę krótsza od starej (23,6 tys. znaków wobec 24,2 tys.), mimo nowych przykładów i reguł.
Gdzie powinna mieszkać wiedza agenta
Na ton agenta wpływały cztery różne miejsca w kodzie, co dało konkretną odpowiedź na pytanie, jak rozkładać jego wiedzę:
| Warstwa | Co zawiera | Kto jest właścicielem | Gdzie u nas |
|---|---|---|---|
| System prompt | persona, ton, sposób prowadzenia rozmowy, zabezpieczenia, przykłady | ekspert PAF razem z programistami | system-prompt.md |
| Definicje kryteriów | co zebrać i jak to oceniać | ekspert PAF | application.yaml |
| Dynamika z kodu | stan kryteriów, komunikat po zapisie stanu, fazy | programiści | AgentTurnPromptRenderer, ReportStepStateResult |
| Frontend | powitanie przed pierwszą wiadomością | programiści | use-chat.ts |
W system prompcie zostaje tylko to, co dotyczy każdej tury i zmienia się rzadko. Rosnąca wiedza domenowa (w Etapie 1 PAF jest siedem bloków, nie cztery kryteria) powinna trafiać do definicji w konfiguracji i być doklejana do tury tylko wtedy, gdy dotyczy bieżącego tematu. Skille, czyli wiedzę ładowaną przez model na żądanie, odłożyliśmy na później, bo ładuje je sam model przez wywołanie narzędzia, a właśnie zobaczyliśmy, jak zawodne potrafi ono być.
Czy biznes może zmienić prompt bez programisty? Technicznie tak, to pliki tekstowe. Ale jedno zdanie w opisie kryterium zmieniło w tym tygodniu klasyfikację sponsora. Najtańsza bezpieczna droga to edycja w webowym edytorze GitLaba, merge request i testy regresyjne promptu w CI przed merge’em. Prompt jest dostrojony do konkretnego modelu, więc wersjonujemy je razem. Narzędzia takie jak Langfuse robią to wygodniej, ale przy jednym agencie git i własne testy wystarczą.
Czego nauczyło nas 10 iteracji prompt engineeringu
- Model kopiuje wszystko, co zobaczy w cudzysłowie. Przykłady, formułki w regułach, opisy kryteriów w YAML-u. Jeśli nie chcesz jakiegoś zdania w odpowiedzi, nie pokazuj go modelowi.
- Test na temacie z przykładów zawyża wynik. Przykłady i scenariusz testowy muszą dotyczyć różnych rzeczy, a swobodna rozmowa pokazuje to, czego nie złapie skrypt.
- Warunek działa, przymiotnik nie. „Nie dawaj opcji w dwóch turach z rzędu” zadziałało od razu, „podawaj je rzadko” nie.
- Reguła oceny należy do definicji kryterium. Wtedy korzystają z niej agent, zapasowe wywołanie klasyfikujące i testy naraz.
- Luźniejszy ton kosztuje kompletność stanu. Warto mieć niezależną kontrolę po stronie aplikacji, zamiast dokręcać prompt.
- Ton agenta to nie tylko system prompt. Znaczenie miały opisy kryteriów, komunikat z Javy i sposób wyświetlania odpowiedzi.
Co dalej
Najpierw test na modelu lokalnym, bo tam kopiowanie przykładów może być silniejsze, a pominięć narzędzia więcej. Potem rozmowa z żywym klientem: nasz ekspert PAF przeprowadzi ją bez skryptu, w innej branży, i oceni na ślepo transkrypty przed i po. Dalej rozszerzenie z czterech kryteriów do siedmiu bloków Etapu 1 i ekstrakcja stanu jako osobne wywołanie, żeby prompt rozmowy mógł w ogóle nie mówić o narzędziu. Na liście drobiazgów zostały rodzaj męski w zwracaniu się do klienta i powtórzenia w części „Dodatkowy kontekst” podsumowania.